MiMo-V2.6
把 RL 的训练、环境与评分一起做大
 Xiaomi MiMo / Figure 3 / PDF P.8 · 下文逐图讲解
如果测试都通过了,为什么模型还可能学会糟糕的工程行为?
这篇报告把中训练、真实环境、评分计算、训练稳定性和蒸馏连成了一条完整链路。适合作为 Agentic Post-Training 的主读本。
原始论文与资料范围
MiMo-V2.6 Technical Report
XiaomiMiMo · 发布 未标注 · 查阅 2026-09-22
完整官方PDF已下载并用pypdf提取文本;核验关键章节,未复现所报告的大规模训练。
本文选读 44 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
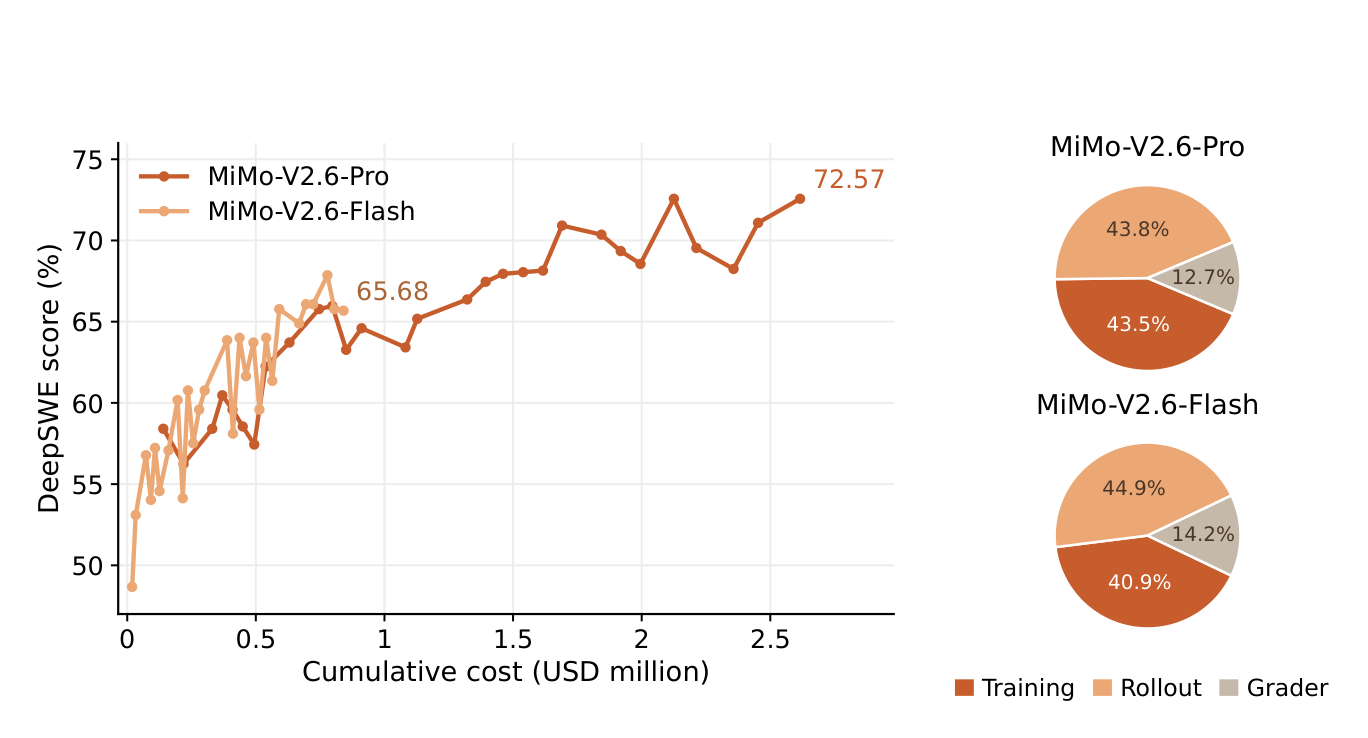
查看来源、版本与许可记录 ↗报告最值得先看的不是榜单,而是 DeepSWE 得分随累计 RL 成本变化的曲线。Pro 从约 58.4 提升到 72.6,Flash 从约 48.7 提升到 65.7。这里是作者报告的 DeepSWE v1.1 average@3 结果;不要把它直接抄成 SWE-bench 的 pass@1,也不要跨 harness 横比。
右侧的成本分解更能解释这篇论文:Pro 的训练、rollout、grader 分别约占 43.5%、43.8%、12.7%。评分已经是需要认真配置的计算系统。 如果只计算反向传播花了多少 GPU 小时,就漏掉了超过一半的 RL 支出。
每步有 1,568 个 prompt,每个生成 16 条候选,即 条序列。报告给出每步约 2.7B–3.7B 训练 token。要把「prompt batch」「trajectory batch」「token batch」分开;长轨迹下它们的比例决定了显存、调度和梯度归一化。
精读重点:这些曲线支持“该配方在这段预算范围内继续受益”。它们不能单独证明增加任何一种 grader 都有效,更不能给出换一套任务后的收益保证。
01左图的横轴是累计 RL 成本,不是参数量;沿同一条曲线观察学习过程。
02右图分别统计 Training、Rollout、Grader。评分开销不能混进免费的后处理。
03average@3 与别的采样预算不是同一个评测协议。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
MiMo-V2.6 的预训练有两个阶段。先只训练语言 backbone,再接入自家预训练的 ViT 和音频编码器,联合训练完整多模态模型。文本包括网页、书籍、论文、代码、STEM;视觉覆盖 OCR、GUI、视频、视觉代码等,音频则被组织成语音文本交错、ASR、音频描述等格式。
Flash 的 48T token 分为文本阶段 26T、omni 阶段 22T;Pro 的 30T 分为 27T 和 3T。这不是“更大的模型必须训练更多 token”的例子。 两者的训练历史不同,不能根据最终榜单把差异全部归因给架构或 RL。
上下文先用 32K,在训练过程中扩展到 256K;优化器是 AdamW。读这部分时,应画出“模态加入时间”和“长度切换时间”两条轴。视觉任务的数据格式决定模型能否读懂屏幕,而 agent 轨迹决定它能否把观察接到后续行动;两者不是同一种训练样本。
报告没有在这一节公开每个数据源的精确采样权重、完整清洗阈值和逐步训练配置,因此不能从 48T 这个总量倒推出可复现的数据配方。
这篇报告明确使用 Mid-Training 一词。 它的目的不仅是延长上下文,还要把通用底座调成适合大规模 agent RL 的起点:加入 coding、general、visual、research 等真实 agent 轨迹,混合高质量文本、仓库级代码和多模态数据;先在 256K 花掉大部分计算,最后扩到 1M。
第二件事是更换优化器。作者在大 batch 混合任务 RL 中观察到 AdamW 的优化效率递减,于是在中训练就为隐藏矩阵换成 Muon 变体 Muown。它在矩阵更新之外加入行范数控制,试图限制谱范数漂移。Embedding、LM head、MoE router 仍使用 AdamW。不要把这一段缩写成“全模型都改用 Muon”。
第三件事是 MXFP4 量化感知训练。它让模型在进入后续阶段前适应低精度计算。这里的训练阶段定位和 Kimi K3 不一样:K3 强调 QAT 覆盖整个后训练,MiMo 在本报告的中训练设置里就引入它。
作者报告切换期间没有 loss spike,但没有给出足够证据让我们断言“AdamW 切 Muon 永远安全”。可迁移的实验是:固定数据与 token 预算,只改变切换策略,记录 loss、更新范数、路由分布,并用同一套后续 RL 验证起点是否真的更好。最后一句是本站建议的实验,不是作者已完成的消融。
代码 agent 的训练样本要包含任务描述、仓库快照、依赖环境、执行方法和验证方式。一次 rollout 则是模型不断读取观察、修改文件、执行命令的完整交互记录。最终 patch 只是记录的一个产物。
MiMo 的环境构造与过滤之所以值得读,在于它检查的不是“问题看上去合理”,而是环境能否运行、任务是否有区分度、判定是否可信。一个因为缺依赖而全部失败的任务,和一个因为能力不足而全部失败的任务,对 RL 的意义完全不同。
Harness 的成功不等于模型能力的成功。 如果 harness 自动修复命令、隐藏错误、注入额外答案,最终分数包含这些贡献。因此任务协议、上下文压缩、重试和超时策略都要进入实验版本。读报告的多 harness 结果时,观察模型是否能跨这些边界迁移。
这一章最容易低估的工程问题是 reward hacking:测试通过,但模型可能依赖答案泄漏、绕过目标行为或破坏环境。把“测试返回 0”当作最终正确性,会把环境漏洞转成梯度。下面的 groupwise grading 正是为通过测试的候选提供更细的判断。
Figure 7 左侧的 GRS 先离线收集同一任务的多条轨迹,让 agent 结合任务、仓库和失败方式写出 rubric。在线时,这份 rubric 被复用,分别评价最终实现和行动过程。奖励是
例如测试奖励为 1,实现质量 0.8,行为质量 0.5,最终是 0.4;若测试失败,即便文字解释很好,奖励仍然是 0。乘法保留了测试门槛,但也让 rubric 的误判直接影响有效训练信号。
右侧的 GAR 不是同一流程换了名字。它在线共同审查组内候选,grader 可以查看代码并执行针对性测试;确认依赖泄漏等 hack 后,先将对应奖励置零,再重新计算组统计。随后在通过的解法间重分配 sequence-level advantage,让质量更高的解法得到更强更新。
要把“奖励重构”和“优势重分配”分开:前者改的是任务分数,后者改的是进入策略梯度的相对权重。对一个全通过组,单纯二元测试奖励没有差异;GRS 可以提供组内差异。GAR 的报告设置则聚焦混合结果组,不应擅自说它覆盖所有组。
分析边界:grader 更聪明并不自动意味着更可靠。需要独立留出的人工审计集、误报漏报率、跨模型评分一致性,以及将 grader 看不到的隐藏测试作为外部校验。
01左半图先离线生成 rubric,再逐条在线评分;注意 Reuse 箭头。
02右半图同时检查一个组;确认 hack 后先修正有效奖励,再重算优势。
03最后都进入 Policy Update,但产生训练信号的位置不同。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
把整条链路写成:任务采样 → rollout policy → 环境执行 → 轨迹存储 → grader → batch 构造 → trainer → 权重同步。GPU 服务、CPU 沙箱和训练 GPU 是三种不同的资源。它们要通过带版本的数据契约协调,而不是共享一个无限队列。
MiMo 的基础设施图把这些职责拆开;Sample Mixer 面向不同任务的异质耗时组织样本。报告中的 rollout 时长分布说明,等待整批最慢样本会浪费大量资源。异步可以减少等待,但同一批里的策略版本也更容易混杂。
理解论文目标函数中的 与 很关键:前者用于处理采样策略与训练策略之间的差别,后者决定哪些 token 真正进入损失。工具观察不应被当成模型自己选择的动作来强化;被截断或无效的轨迹也不能丢失其状态信息。
路由稳定性同样会回到 RL。报告分析了 router imbalance 和训练中断,并讨论路由冻结等措施。一个常见误读是“loss 没有 NaN,所以稳定”;实际上负载偏斜可以先拉长 rollout,继而改变任务采样分布和策略新鲜度,最后才反映到奖励。
打开本页的 rollout 实验,将允许版本差调小,比较丢弃率和训练利用率;再将环境耗时分布拉长。教学模拟展示调度权衡,不复现 MiMo 的集群性能。生产排查还需 p50/p95/p99 轨迹耗时、每类任务完成率、队列深度、策略版本差和各角色 GPU 利用率。
01先找生成轨迹、运行环境、计算奖励和更新权重的不同组件。
02追踪样本从 rollout 到训练的边界,记下哪些数据必须持久化。
03反向追踪权重更新,思考在途轨迹是否仍来自同一策略。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
标准 on-policy distillation 让学生在自己的分布上生成,再由教师评估这些 token;它与先收集完整教师答案再 SFT 的区别是 谁决定训练中见到的上下文。长轨迹中,学生可能在很早的决策处偏离教师,后续状态就完全不同。
MiMo MOPD2 在多教师在线蒸馏之外引入 prefix-conditioned single-turn rollout。Figure 13 要分三块读:领域教师怎样得到;普通 MOPD 怎样在学生生成上提供信号;给定前缀的单轮采样怎样让监督触达长轨迹内部的状态。
教师来源也不单一:可验证领域可以用 MixRL 教师,开放任务可以用合成示范训练 SFT 教师。这一设计把“教师从哪里来”和“学生怎么学”解耦。不要把所有领域的分数都当成同一种可验证奖励。
本站建议的阅读练习:任选一次工具失败,分别画出离线教师轨迹 SFT、学生整条在线 rollout、前缀条件单轮 rollout 的训练上下文。三张图如果画成一样,说明还没有理解 distribution mismatch。
01先看 domain-specialized teachers 的训练来源。
02在 standard MOPD 中找 student rollout,识别策略分布由谁决定。
03在 prefix-conditioned 分支找单轮边界,思考它如何进入多轮轨迹内部。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
合上论文后,
留下这几件事。
- 大规模 Agentic RL 的预算必须同时包含训练、rollout 和 grader。
- Mid-Training 可以同时承担数据、优化器和精度的阶段适配。
- GRS 改奖励,GAR 重分配优势;通过测试只是质量判断的一部分。