GLM-5
从长上下文中训练,到异步 Agentic RL
 Z.ai / 智谱 / Figure 5 / PDF P.4 · 下文逐图讲解
一条轨迹跨过几次权重更新之后,它还算 on-policy 吗?
这里选 GLM-5 技术报告,因其训练阶段和异步 RL 细节充分;不把它冒充更新版本 GLM-5.3 的完整训练披露。
原始论文与资料范围
GLM-5: from Vibe Coding to Agentic Engineering
Z.ai / GLM-5 Team · 发布 2026-02-17 · 查阅 2026-09-22
5.3模型卡引用家族报告;本课不把家族早期报告冒充完整5.3配方。
本文选读 40 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
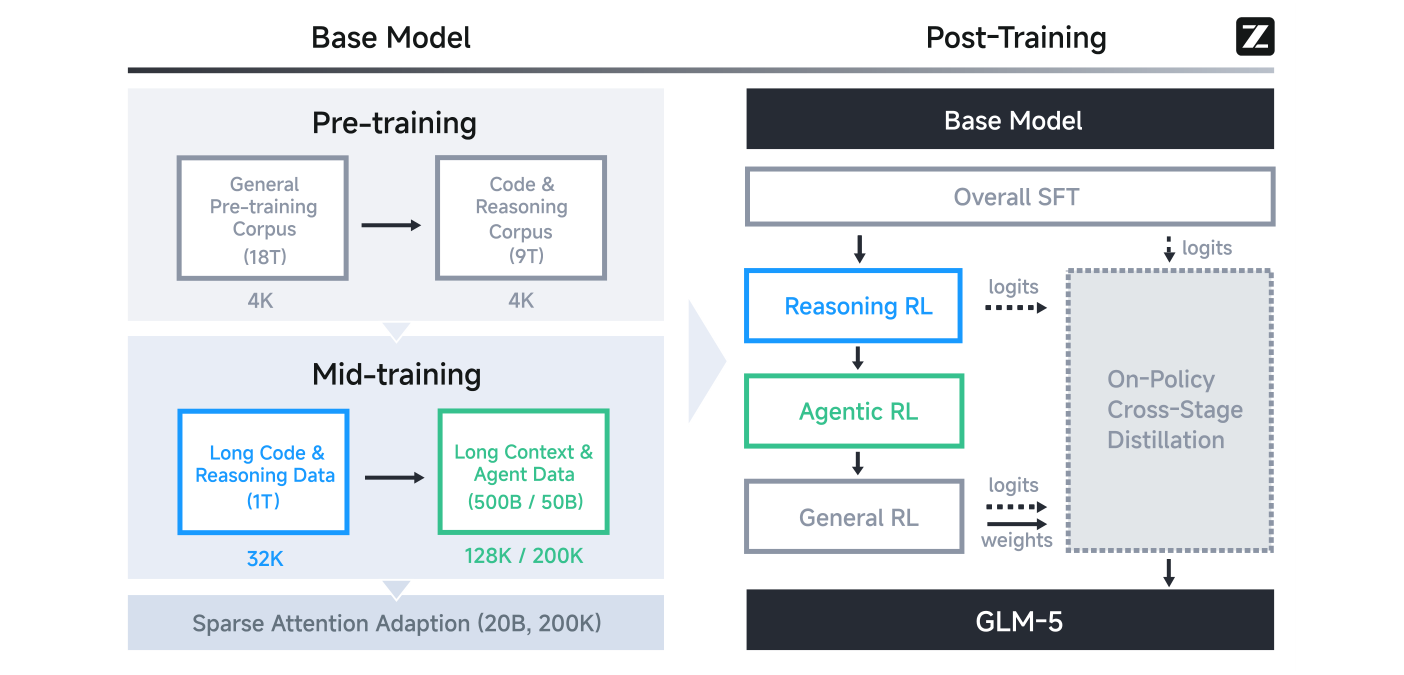
查看来源、版本与许可记录 ↗GLM-5 明确区分预训练和中训练。后者按 32K / 1T token、128K / 500B、200K / 50B 逐步扩展。长文档和合成 agent 轨迹在后段被提高采样权重,长度与能力数据同步变化。
软件工程数据把仓库文件、commit diff、issue、PR 和相关源文件组织成统一上下文。报告扩大仓库覆盖,并加强单 issue 质量过滤;约 160B unique token 是过滤后的 issue–PR 部分,不是整个中训练 token 总量。
长上下文同时有自然文档与构造依赖的合成样本,避免只是把不相关短文拼长。报告观察到 200K 阶段还改善 128K 内的表现;这支持该设置下的迁移收益,不表示只要增加长度就一定有效。
01第一次只看 Base Model:通用 → 代码推理 → 中训练 → 稀疏注意力适配。
02第二次看右侧 SFT、不同 RL 与在线蒸馏,区分阶段教师与最终学生。
03图中的 token 数分别对应阶段,不能把局部数据量误当总语料量。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
训练与推理放在不同 GPU,推理持续生成轨迹;达到数量阈值后送入 trainer,再周期同步新权重。长任务不用等所有短任务结束才统一启动,但不同轨迹甚至一条轨迹内部可能跨多个策略版本。
报告记录每条响应经历的版本序列,并按最旧版本与当前版本的差距丢弃过旧样本。它还复用 rollout log-probability 作为行为分布代理,以降低维护历史 policy 的成本,明确接受受控的 off-policy 偏差。
TITO(token-in-token-out)直接保留采样 token ID 和元数据。若只保存文本,trainer 重新 tokenize,空格、特殊 token、截断和工具边界可能变化,计算的概率就不再对应实际选过的动作。这是概率比能否有意义的前提,不只是序列化偏好。
GLM 的双侧校准对超出区间的 token 直接 mask,而非把 ratio 截到边界。不要把它一律描述成 PPO clipping。复现必须检查 mask 在哪生成、梯度是否穿过 ratio、归一化分母是否包含被丢弃 token。
报告过滤因环境本身崩溃而失败的样本,避免把基础设施故障当模型能力失败。对于组内缺样本,若有效样本超过半数,用有效样本补齐;否则整组丢弃。这是作者的具体处理,不是所有 GRPO 系统通用规则。
对照 V4.1 把 agent 破坏环境视为失败轨迹的描述,会发现两者并不必然矛盾:故障原因归属不同。训练数据应保存可审计的 failure_reason,不应把所有 exit nonzero 都过滤,也不应把所有 sandbox crash 都当负奖励。
补齐同一条轨迹会改变样本权重,丢组会改变任务分布。最终需要按任务难度和故障类型观察保留率,否则系统稳定性可能悄悄决定 curriculum。
练习:给 8 条轨迹分配“模型错误”“环境故障”“超时”“成功”,分别执行两套过滤策略,计算有效组的数量和优势。写出哪些信息不足以自动判定,不用猜测填补日志。
slime 以 HTTP 服务接口解耦任务逻辑和训练,支持工具、环境反馈和多轮交互。某个任务的 harness 可以独立实现,但输出必须回到统一轨迹表示与精确 token 数据。
长轨迹的尾延迟决定 batch 等待。FP8 rollout 与 MTP 减少每 token 延迟;PD 分离避免长前缀 prefill 挤占正在进行的 decode;按 rollout 固定 DP rank 的亲和路由则保留 KV cache 局部性。它们优化的瓶颈不同,不能只写一个“吞吐提升”。
报告还通过 heartbeat 和路由注销处理故障服务器。重复执行工具可能有副作用,因此恢复需要明确请求 ID、环境状态和是否完成,不能只对 HTTP 请求无限重试。
本页 rollout 实验展示同步等待、过旧丢弃和有效吞吐之间的关系。读源码时优先看 rollout → sample / token IDs → batch → loss mask 这条链,而不是把整个 slime 仓库从头看完。
各阶段 checkpoint 成为教师,学生在对应任务 prompt 上生成,再由教师概率差提供 token 信号。报告在这个阶段将 group size 设为 1:优势来自 teacher / student 差别,不再需要同题多个样本来估计组内 baseline。
这能帮助理解“同一个 RL 框架”与“同一种 RL 算法”不是一回事。框架可以复用采样、推理、权重同步与 trainer,但训练信号已经从任务奖励变成密集蒸馏反馈。
继续读 Kimi K3 的九专家和 MiMo MOPD2,比较教师分工、学生采样分布、token 级权重与长轨迹处理;这些才是值得跨模型迁移的阅读维度。
合上论文后,
留下这几件事。
- 精确的行为 token 与概率是异步训练的数据契约。
- 模型失败与基础设施失败需要不同处理。
- 推理尾延迟、cache 亲和与权重同步直接影响 RL 效率。