Kimi K3
从混合架构到多教师,重新分配每一份计算
 Moonshot AI / Figure 2 / PDF P.3 · 下文逐图讲解
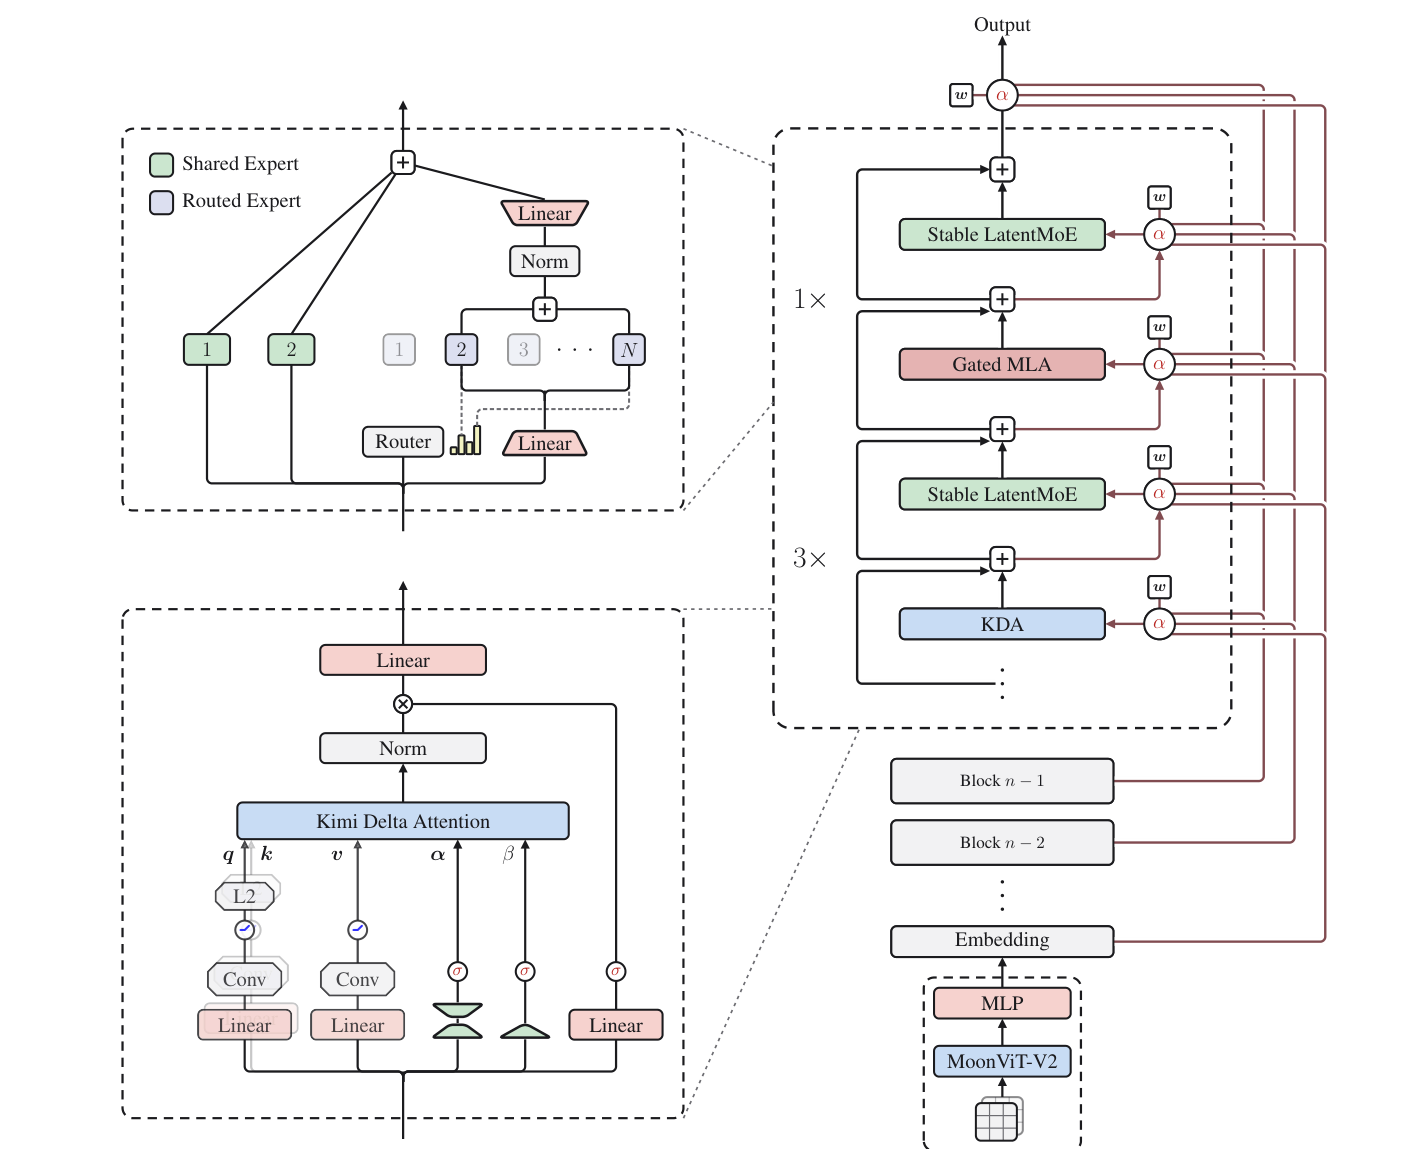
怎样同时沿序列、深度、宽度三个方向改善信息流?
K3 不只是 K2 的规模更新。它把混合注意力、层间信息流、专家压缩与部署感知后训练放在一起,适合和旧代逐项比较。
原始论文与资料范围
Kimi K3: Open Frontier Intelligence
moonshotai · 发布 未标注 · 查阅 2026-09-22
完整官方PDF已下载并用pypdf提取文本;核验关键章节,未复现所报告的大规模训练。
本文选读 47 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗K3 的图可以沿三个方向读。沿 token 方向,每组三层 KDA 加一层 Gated MLA;沿网络深度,AttnRes 让后面的层有选择地读前面的表示;沿通道宽度,Stable LatentMoE 在较低维的 latent space 内执行路由专家计算。
KDA 的有限状态可以压缩前缀,长序列下成本更低,但有限状态并不等同于精确保留每个历史 token。因此还需要 MLA 这类全局注意力作为检索通道。混合比例是在压缩与直接访问之间做分工,不是说线性注意力已经全面替代 softmax attention。
LatentMoE 的关键也不是只减少专家数,而是让昂贵专家在缩小的表示空间工作,再投影回主干。这样改变每 token FLOPs,同时引入信息瓶颈与训练稳定性问题;报告的稳定化设计和负载均衡要与压缩一起读。
AttnRes 让层间连接从固定累加变为可选择的信息读取。把它与 Qwen3.8 的 Gated Residual 比较时,应问“保留什么历史表示、谁计算读权重、需要搬多少字节”,而不只说两者都改了残差。
01右侧 3× KDA 与 1× MLA 负责 token mixing 的分工。
02跨层连线说明信息如何绕过中间层,被后续层再次读取。
03左上 LatentMoE 的投影决定专家处理的实际表示维度。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
预训练语料覆盖 Web、Code、Mathematics、Knowledge 和视觉数据。此处应关注“这些领域在训练中承担什么作用”,而不是把一个总 token 数当作质量指标。报告将更新后的数据与架构组合进行 scaling 比较,因此整体增益不能未经消融就归给某个单独模块。
Muon 在 K3 中进一步按 head 处理注意力投影的动量块。全矩阵正交化会把多个 head 作为耦合整体;per-head 版本分别归一化不同 head 的更新方向,避免大尺度 head 支配共同更新。Newton–Schulz 的实际矩阵形状变小,也会改变 optimizer 的计算开销。
Figure 7 的训练效率比较需要同时检查横轴计算量、模型规模和数据配方。报告给出的约 2.5 倍整体训练效率提升属于其比较设置;不能把这个数字乘到你的 GPU 峰值或所有下游任务上。
建议用一张账本记录每个候选:训练 FLOPs、真实 step 时间、验证 loss、base benchmark、长上下文行为。对于混合架构,再加上 recurrent state 与全局 KV 的内存。这样才能解释为什么理论 FLOPs 下降后,部署速度未必按同样比例上升。
K3 报告把 context 从 8K 扩到 64K,之后在 cooldown 中进一步走向 256K 和 1M。长度增加时,一个 batch 能放下的序列数、激活占用以及样本分布都会变化。模型能接受 1M token 和能有效利用 1M token 不是同一证据。
报告还明确使用 NoPE:不添加显式位置 embedding,而依靠 KDA 的递归门控与衰减隐式表达位置信息。因此它向 1M 扩展时不需要 RoPE 重缩放;这与 Qwen3 的位置适配路线不同。但不改位置编码不代表不用训练:作者仍清洗、去重并上采样真正连贯的长文档与视频,再合成必须利用分散信息才能解决的长程任务。
这里的术语是报告的预训练与 cooldown 描述。本站将其放进 Mid-Training 路线,是为了对照“底座之后的能力塑形”,不把自己的课程分类冒充 Moonshot 官方阶段定义。
尤其不要把后训练的 MXFP4 QAT 提前写成整个预训练都使用 MXFP4。报告将这项部署感知训练明确放在后训练,覆盖 SFT 与 RL。不同精度处理的组件范围也不是全模型统一量化。
读到阶段切换时,留四个问题:训练了什么数据、长度是多少、学习率怎样变化、后面用什么评测确认能力保留。报告未给出的完整配比和逐步 schedule 就应保留未知,而不是用其他代模型的参数填空。
RL 覆盖 general、general agents、coding agents 三个广域;再与 low、high、max 三种 reasoning effort 组合,形成九个专家模型。这些是训练中的教师角色,不是用户请求时临时拼接的九个 API。
学生在给定领域和 effort 的条件下生成;对应教师在学生前缀上打分。报告给出 clipped、stop-gradient 的 token 级对数概率比作为密集信号。其核心可写成
教师认为某个学生 token 相对更合理时,它得到向教师靠拢的信号。sg 表示这一项作为训练权重使用时不再沿该权重反传;不能忽略它再声称目标完全相同。组相对任务奖励与 token 密集蒸馏信号的来源不同,因此不是“一切都是同一种 GRPO”。
QAT 则对占主要参数量的 MoE 专家权重用 MXFP4、激活用 MXFP8,attention 等非专家组件保留较高精度。rollout 与 trainer 采用一致方案,目的是减少训练采样分布与优化分布不匹配。报告还把预训练 MTP 微调为 EAGLE-3 风格 draft;这部分优化的是部署接受率,不应算成底座推理能力的独立提升。
报告把 harness 拆成工具接口、system prompt、上下文管理、skills、memory、subagents 等可配置模块。多种组合可以构成不同 agent 运行方式;这允许训练中变化 harness,检验策略是否只是记住一种协议。
这点对读论文很重要:一个框架能自动搜索、压缩上下文、派生子任务,并不说明 policy 自己学会了这些能力。应比较同一模型换 harness 后的结果,以及同一 harness 换模型后的结果。报告的统一环境是系统设计,最终任务得分仍是模型与系统共同作用。
任务合成还需要可验证性。模型可以生成难题,也可能生成没有正确答案、环境不可解或验证器错误的题。难度估计、可执行检查和独立验证要连成闭环;不能用同一个未经校准的模型同时出题、答题、宣布自己正确。
本站练习:从一段完整轨迹标出模型 token、工具响应、自动注入的提示和上下文压缩结果。然后问 loss mask 应该覆盖哪些位置。只有能标对这些边界,才谈得上复现 agent RL 的目标。
流水线 warmup 时,前向执行领先反向传播,尚未使用的激活不断堆积。K3 报告图中的 offload 与 reload 试图把这段等待时间转成显存空间:前向之后移出,反向之前搬回,并与计算和通信重叠。
重叠不是免费带宽。 PCIe / NVLink、CPU 内存、跨节点网络和 GPU 执行资源可能争用。看图时先标出每条时间线使用什么资源,再找依赖关系。如果 reload 还没完成,反向 kernel 再快也只能等。
混合架构还增加 cache 管理复杂度:KDA 保存递归状态,MLA 保存全局注意力所需状态,前缀复用要保证不同类型状态对应同一个 token 边界。只缓存文本而不保存准确的状态版本可能造成难以复现的输出差异。
实操从单卡 profiler 开始:看 kernel 持续时间、显存峰值、数据拷贝是否与计算重叠。再去集群测通信。本站系统实验中的带宽是用户输入的假设,不冒充报告硬件测量;已有 PyTorch 实测也只代表运行它的本地 GPU。
01Warmup、steady state、cooldown 的激活生命周期不同。
02分别追踪计算、通信和 host offload,找出谁必须等待谁。
03图是调度示意;真实重叠比例必须用 trace 测量。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
合上论文后,
留下这几件事。
- K3 在 token、layer、channel 三个方向改造信息流。
- 在线蒸馏让教师评价学生分布里的状态,QAT 将部署精度带入后训练。
- 混合架构的性能依赖状态管理、算子和通信,而不仅是 FLOPs。