Qwen3.8-Flash-Next
最值得学的,是那些没有被采用的设计
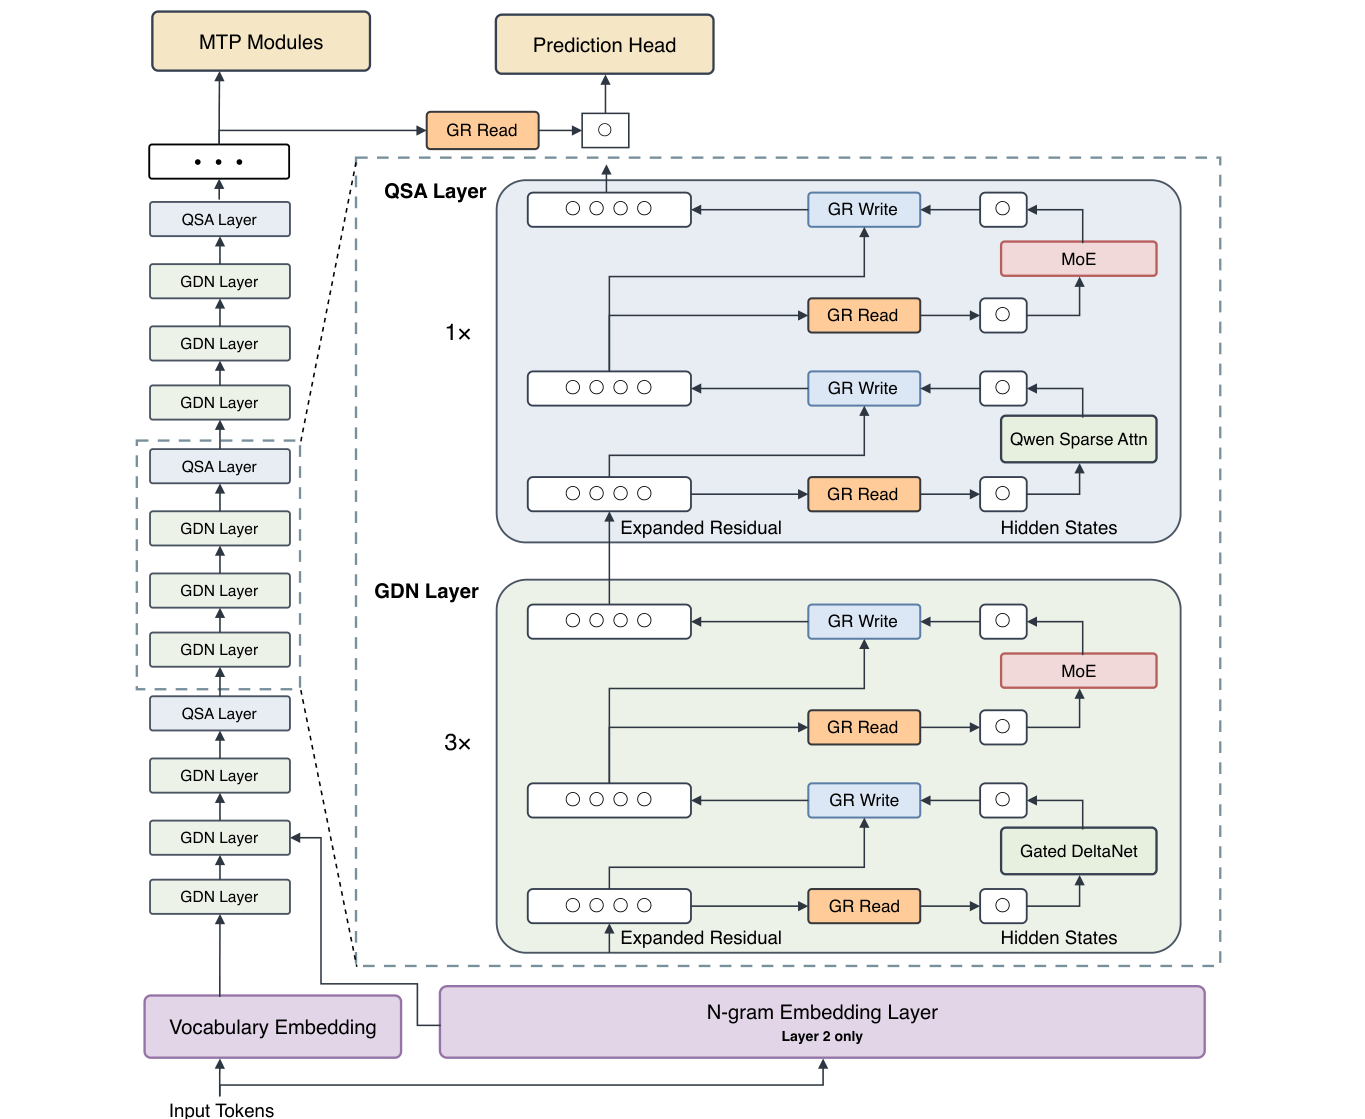 Qwen / Figure 1 / PDF P.2 · 下文逐图讲解
如果预训练 loss 更低,下游能力为什么还能变差?
这是一份架构与消融报告,不是假装完整披露全部后训练。它同时观察 loss、下游评测、效率和稳定性,尤其适合学习怎样做训练决策。
原始论文与资料范围
Qwen3.8-Flash-Next Technical Report
Qwen · 发布 未标注 · 查阅 2026-09-22
完整官方PDF已下载并用pypdf提取文本;核验关键章节,未复现所报告的大规模训练。
本文选读 28 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗这份 2026-08-26 报告讨论 Qwen3.8-Flash-Next:125B 参数的 backbone、每 token 激活 6B,另有放在 accelerator 外的 51B n-gram embedding 参数。不能把它当成 Qwen3.8 所有产品的统一结构,也不能只报 6B 就说它只需要一张小卡。
每四层有三层 Gated DeltaNet 和一层全局注意力;CPT 中再将全局注意力替换为 QSA。GDN 用固定大小状态压缩历史,全局注意力保留直接检索通道。残差流扩成四个分支,由 Gated Residual 决定怎么读写;第 2 层加入 n-gram 记忆。
报告相对 397B-A17B 前代的比较同时改变了激活参数和训练 token,约九分之一训练 FLOPs 是这一组合设置下的结果。不能由此声称每个组件各自带来九倍收益。 Base benchmark 的改善也不等于已证明所有最终 chat / agent 能力都更强。
01左边先看 GDN / QSA 的 3:1 层间比例。
02右边 read / write 围绕每个子层,决定扩宽残差怎样被使用。
03底部 n-gram table 与顶部 MTP 各自服务不同的容量和推理目标。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
QSA 在 256K 的 continued pretraining 中引入,分 dense distillation 与 sparse training。它先让轻量 indexer 学习全注意力的选择偏好,再把主注意力限制在选定位置,避免一开始就随机丢失重要上下文。
输入被分成 micro-block。key 先平均池化,再加位置编码;若先对每个 token 旋转后平均,就会混合不同相位。query 只能给已经完整观察到的块评分,末尾未完成块另行包含,因果性落实在具体块边界上。
教师给出 token 级注意力分布,报告用 max pooling 对齐到 block 粒度,再归一化成蒸馏目标。这里平均池化 key 与最大池化教师分数不是矛盾:前者构造块表示,后者尽量保留块内显著 token 的信号。
对于长度 N、块宽 r,索引候选数约降到 N/r,但选块后主注意力仍需访问实际 token。增大 r 会降低索引成本,也可能把许多无关位置一起带入。应看效率和检索质量的消融,而不是只记复杂度更小。
作者观察到残差分支的权重常由少数分支主导,于是尝试只使用 gate 最大的两个分支。预训练 loss 和 benchmark 几乎不变,后训练质量却明显下降,所以未采用。原文在 read/write 的措辞中有交替,能确定的结论是这个 top-2 分支稀疏方案被否决,而不是自行补一个未公开实现。
这是整个网站要反复强调的实验:候选架构必须经过后续阶段。预训练 loss 只说明对当前数据的拟合,不能完整度量 RL 可探索的策略空间、指令遵循或长期任务行为。本文报告的是现象;具体退化机制仍需进一步实验证实。
另一个候选更成功:残差状态用 FP8 存储,读写各融合为 kernel,减少移动字节。它没有强迫只留下两个分支,而是以较低精度保留容量。对比之下,容量压缩与数值压缩改变的是不同东西。
n-gram table 扩大也会持续降低 loss,而下游收益趋于饱和。读取表格时分别标注最佳 loss 和最佳能力,两列可能不是同一行。本站建议为架构评审保留一个“拒绝的方案”页,写清是哪项后续测量推翻了初始判断。
Qwen 对 q/k/v、GDN 投影、专家 fc1/fc2 等真正的线性映射用 Muon;输入 embedding、输出 head、router 和部分残差投影保留 AdamW,n-gram table 用不带 weight decay 的 Adam。报告观察到对 router 用 Muon 会加剧早期波动,中后期也没有显著收益。
生产框架常把 QKV 或 gate/up 拼成一块连续内存。物理上是一块参数,不代表算法上是一个线性算子。 直接对融合矩阵做正交化,会混合独立子块的奇异方向,按拼接后的 shape 缩放更新也会偏离原来含义。因此先拆梯度,按 head 或 gate/up 分别处理,再拼回布局。
Muon 需要完整矩阵,而 TP 将矩阵切到不同 rank。报告中的 Canzona 将 optimizer 的逻辑所有权与参数物理布局分开,通过 All-to-All 重组矩阵,并按估算的 Newton–Schulz FLOPs 分配 owner。相同参数元素数不意味着相同正交化成本;短边维度对成本尤其重要。
拆分后又出现许多小 kernel,launch overhead 可能超过算术本身,因此使用 CUDA graph。这个案例完整展示了“算法选择 → 矩阵形状 → 通信 → kernel 调度”的链条。源码没有在本页逐行展开;可从本页系统补充入口定位已经核验的 kernel / 通信案例,再用 profiler 验证相同机制。
作者没有只展示最终大模型一条漂亮 loss 线,而是在小模型上提高学习率等条件做 stress test。Figure 10 比较 AdamW、Muon、Muon + GR 在恒定学习率下的训练轨迹。它把 optimizer 与架构稳定性放进同一个实验,而非事后把所有 spike 都归因于数据。
看图先区分粗线与淡线:平滑曲线显示总体趋势,未经平滑的波动展示异常。只保留滑动平均会掩盖尖峰;只看单个极值又可能夸大短暂噪声。结合 gradient norm、activation 和 clipping 频率,才知道异常是否改变了优化过程。
报告还重新拟合 batch 与学习率的关系。新的结构改变最佳超参数,因此把旧配方原样套上去后比较性能,未必公平。架构、优化器、超参数是一个实验整体,但这也意味着需要足够消融才能归因。
练习:为一个候选列四栏——loss、下游评测、每步时间、稳定性;要求用同预算对照。在其中任一栏明显变坏时,写出是否接受的理由。不是所有指标都必须单调更好,但取舍必须明确。
01两幅图是不同学习率强度的压力设置,不能混为同一运行。
02先看尖峰和恢复,再看最终 loss;不要只比较最后一个点。
03这是小规模 stress test,证明边界不同于完整集群故障率。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
合上论文后,
留下这几件事。
- loss、下游、效率和稳定性可能相互冲突。
- CPT 可以用于结构适配,且需要清晰的因果与蒸馏接口。
- 参数的内存布局、语义分组和 optimizer 分片不是一回事。