FlashAttention
把注意力的中间矩阵留在芯片上
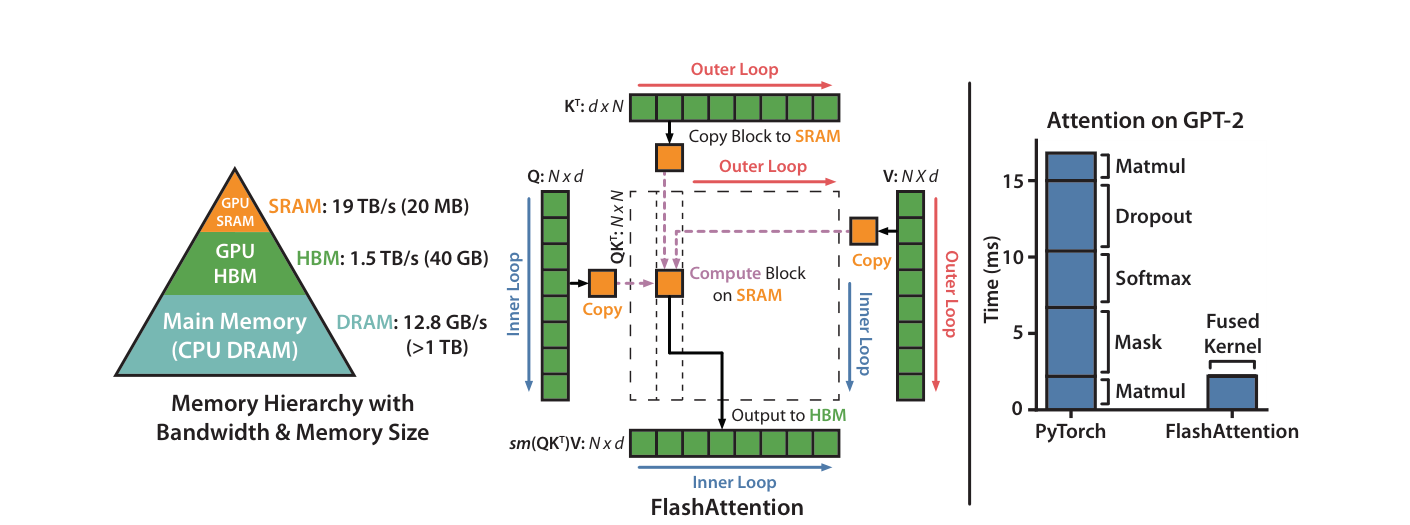 Stanford 等 / Figure 1 / PDF P.2 · 下文逐图讲解
计算相同的精确注意力,为什么少搬数据可以更快?
这是从理论进入 GPU 的最好入口之一。重点是 IO 与算子调度,随后再读新版本 kernel 或新架构。
原始论文与资料范围
FlashAttention: Fast and Memory-Efficient Exact Attention with IO-Awareness
Dao et al. · 发布 2022-05-27 · 查阅 2026-09-22
引用公开论文的结论范围;没有完整代码的训练细节不从论文推测。
本文选读 34 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗HBM 容量大,但从计算单元反复读取它有代价;片上 SRAM 更快但小。普通注意力显式保存 与 ,大小都是 ,写回再读出中间结果会产生大量 IO。
FlashAttention 将 Q/K/V 分块搬到片上,计算局部贡献并累积输出,避免在 HBM 中物化完整二次大小矩阵。它首先是精确注意力的 IO 优化,不是通过删掉远处 token 换速度。 论文另讨论的 block-sparse 扩展要分开。
一张卡的理论 FLOPs 不能说明 kernel 一定跑得快。若计算单元在等内存,增加峰值算力没用;如果块太小又会产生更多调度开销。算术强度、片上容量和实际硬件共同决定最佳 tiling。
01先读存储层次,再追踪标准实现的中间矩阵。
02分块方法保留统计量与输出累积,避免完整注意力矩阵物化。
03图中的速度结果对应原论文设备与任务,不代表任意新 GPU 的倍数。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
对一行分数,保存当前最大值 m、指数和 l 与未归一化输出累积 u。新块到来时,最大值可能变成 ,旧贡献需要乘 重新缩放,才能和新块在相同数值尺度上相加。
所有块处理后输出 。这解释了为什么不能把各块各自 softmax 后直接平均:不同块的归一化分母不同。数值稳定的在线合并才使 tiling 保持整体注意力语义。
反向传播也不一定保存全部中间矩阵;利用前向保留的统计量进行重计算,以增加部分 FLOPs 换取更少 HBM 读写。算得更多却跑得更快,在 memory-bound kernel 中并不矛盾。
测试时应固定 batch、head 数、head dim、序列长度、dtype、causal mask、dropout 与前后向范围。只比一个 forward 的时间,不能得出整次训练 step 同比例加速。
GPU 是异步执行的,普通 wall-clock 只包围 kernel launch 会低估耗时。应 warmup、用 CUDA event 或正确 synchronize,再统计多次运行;profile 要同时看显存与 kernel 时间。本站的 PyTorch profiler 实验已保存一组本地运行记录,明确区分 CPU 与 CUDA,不伪造集群数据。
在生产系统中,attention 更快后,瓶颈可能转到 MLP、MoE all-to-all 或 optimizer。继续读 V3 的通信重叠与 Qwen3.8 的融合 optimizer,才能把单算子优化接回整条训练时间线。
合上论文后,
留下这几件事。
- 精确注意力可以通过 IO 优化加速,复杂度与硬件时间不是同一件事。
- 在线 softmax 的统计量合并保证分块语义正确。
- 性能比较必须固定 shape、精度和测量范围。