DeepSeek-V3
一份把算法、算子和集群连起来的训练报告
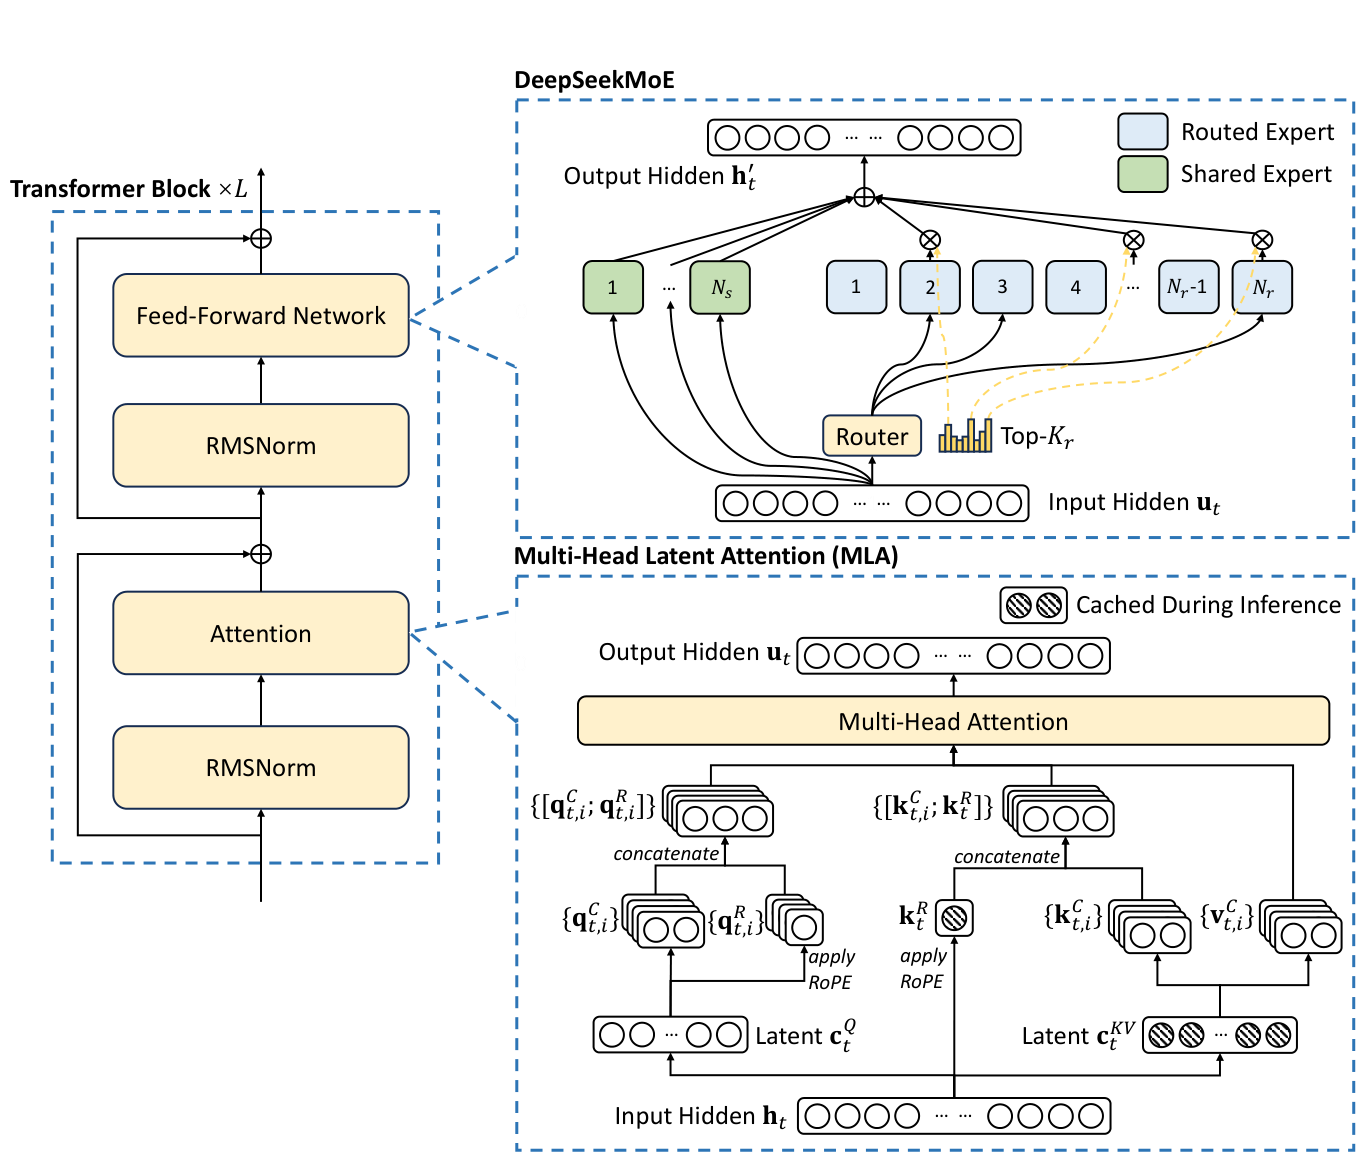 DeepSeek / Figure 2 / PDF P.7 · 下文逐图讲解
稀疏模型省下的计算,怎样才不会被通信和数值误差吃掉?
虽然不是最新代,V3 的公开系统细节仍是读新架构的好底座:路由、FP8、并行和部署都有可定位的说明。
原始论文与资料范围
DeepSeek-V3 Technical Report
DeepSeek-AI · 发布 2024-12-27 · 查阅 2026-09-22
公开报告不等于完整训练代码或数据已发布;课程不补全未公开实现。
本文选读 53 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗V3 继承 MLA 与 DeepSeekMoE。前者压缩注意力所需的 KV 表示,降低推理 cache;后者用少量被选专家的计算连接更大的总参数容量。一个主要处理注意力状态,另一个主要处理前馈计算,不要把两者都混称为稀疏注意力。
MLA 中 是压缩 latent,内容 key/value 再由它投影出来;位置编码分支单独处理,避免旋转位置编码破坏可以吸收的矩阵结构。读 Figure 2 时先追踪哪些张量在 inference 时需要保存。
路由的难题是专家偏载。V3 使用用于选择的 bias 调节专家命中频率,减轻把大负载均衡损失加到语言建模目标上的干扰。bias 影响选择与真实 gate 权重的角色要分清;报告仍保留小的 sequence-level balance loss,因此“auxiliary-loss-free”不能机械理解为整个训练没有任何平衡损失。
01右下方 MLA 标出的 cache 决定每个历史 token 要保留什么。
02右上方共享专家与路由专家决定每 token 实际执行哪些 MLP。
03MoE 容量收益以通信和负载管理为代价,并非全部参数都免费。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
V3 在 14.8T token 上预训练,强调数学、编程与多语言的覆盖和数据质量。这里的公开报告能够说明方向和若干配方,不能还原全部数据集来源、过滤器与采样阈值。
Multi-Token Prediction 在主 next-token loss 之外加入多个未来位置的辅助预测。每个深度仍维持因果链,将前一深度表示与相应 token embedding 组合后送进模块。辅助损失可概括为 。
这不是让主模型一次随意输出多个不相互依赖的 token。训练时额外目标塑造表示;推理时可丢弃 MTP 模块,或把它用于 speculative decoding。因此比较能力时应区分训练收益和部署加速收益。
长上下文也单独经历适配。将 V3 与 Qwen3 对照,可以看到数据再平衡、学习率退火和长上下文不是新模型才突然出现的技巧,而是不同团队逐步系统化的训练阶段。
报告对 activation 使用 1×128 tile、对 weight 使用 128×128 block 的细粒度缩放,并分析 H800 上累加精度的限制。关键不是把数值都转成 8 bit,而是控制动态范围、累加误差与缩放成本。
Tensor Core 执行矩阵乘加,部分和周期性转到 CUDA Core 的 FP32 寄存器累加,以减少大 K 下的误差。这个方案会影响指令发射和流水线,因此还要安排不同 warpgroup 的重叠。
master weight 和梯度累积保留 FP32;某些 AdamW 状态使用 BF16;通信中的 dispatch 和 combine 也并非都用相同精度。训练精度是一张按张量生命周期填写的表。 若只在 README 写“FP8 training”,几乎无法判断实现是否等价。
缩小实验应比较输出误差、梯度误差、更新后 loss 和真实运行时间,而不是只比较显存。本站 GPU 实验提供真实 profiler 入口;没有 FP8 硬件的机器可以先测 BF16,不能伪造 FP8 的加速值。
报告集群有 2,048 张 H800,每节点 8 张,节点内 NVLink / NVSwitch,节点间 InfiniBand。训练组合 16-way PP、64-way EP 和 ZeRO-1 DP。并行维度可能共享或组合 rank 组,不能把所有数字无条件相乘解释成独立 GPU 数。
一个 token 先由 router 选择专家,再 dispatch 到专家所在卡,执行 MLP,最后 combine 回到原 token 位置。跨节点和节点内走不同链路;平均通信量之外,最忙专家和最慢链路决定 step 尾部。
DualPipe 将前向和反向进一步分成 attention、dispatch、MLP、combine 等块,安排计算与通信重叠。Figure 4 中反向 input gradient 与 weight gradient 还承担不同依赖:前者经常在上游梯度的关键路径,后者可以被延后利用空隙。
部署的 prefill 与 decode 又使用不同的最小单元和并行策略,不能照搬训练拓扑。先把训练目标“单位时间更新更多有效 token”和服务目标“满足延迟下提高吞吐”区分开,再读配置才有意义。
01Dgrad 决定向前一层传梯度的时间,Wgrad 更新本层参数的梯度。
02通信被放进其他计算的间隙,而不是在每一层末尾统一等待。
03时间线解释调度关系,不代替你所在硬件的带宽测量。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
合上论文后,
留下这几件事。
- 架构、数值格式、通信和调度共同决定效率。
- MTP 的训练目标与推理用途要分别归因。
- 公开 GPU 小时是特定训练范围,不是公司全部研发成本。