DeepSeek-V4.1
把长上下文的能力与代价一起重做
 DeepSeek / Figure 3 / PDF P.7 · 下文逐图讲解
为什么新一代模型既要改注意力,也要改数据与环境?
它展示了架构与服务共同设计的前沿,同时明确声明后训练重点在数据和环境,适合纠正“每代进步都来自新 RL 算法”的直觉。
原始论文与资料范围
DeepSeek-V4.1 Technical Report
deepseek-ai · 发布 未标注 · 查阅 2026-09-22
完整官方PDF已下载并用pypdf提取文本;核验关键章节,未复现所报告的大规模训练。
本文选读 51 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
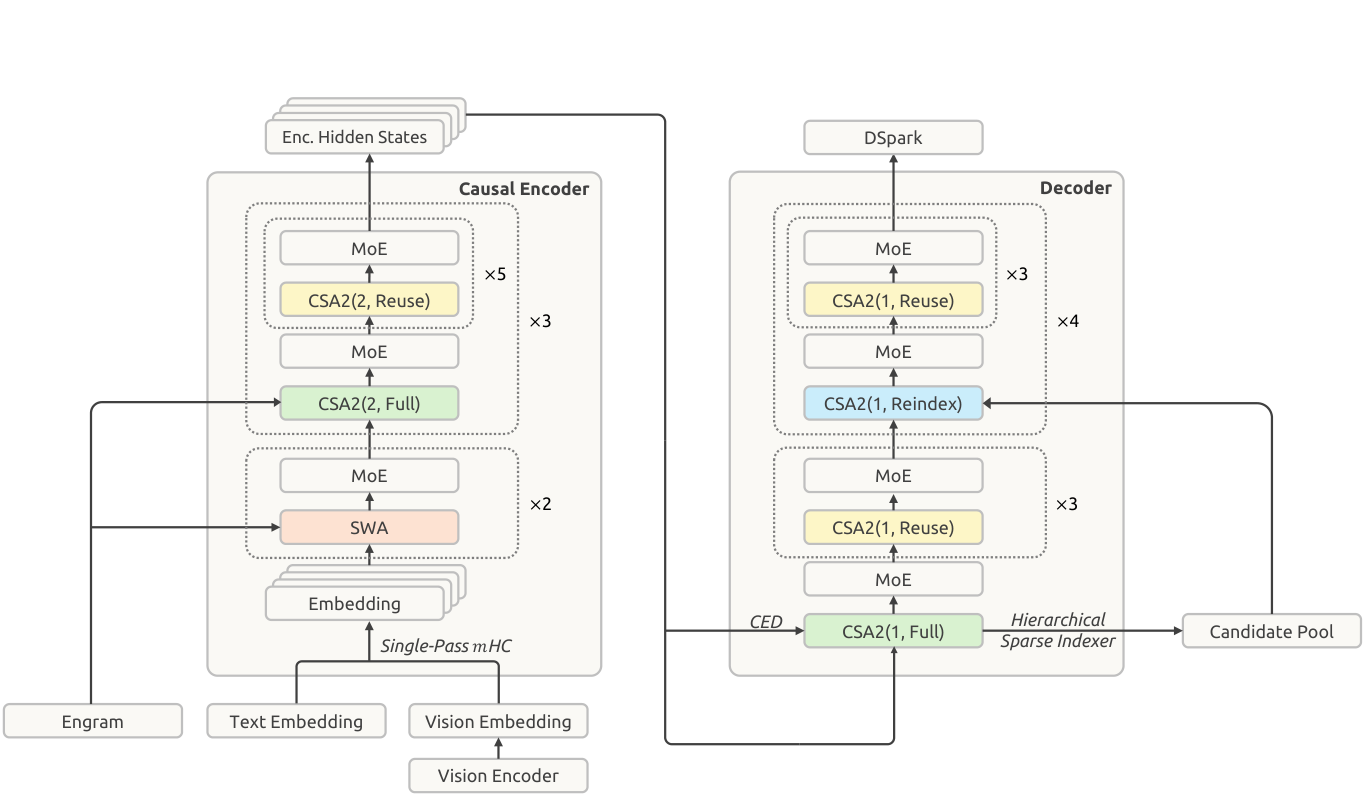
查看来源、版本与许可记录 ↗这份报告研究的是 DeepSeek-V4.1-Flash,不能把 Flash 的配置外推给所有同代产品。语言 backbone 共 40 层,分为 20 层 causal encoder 和 20 层 decoder。这里的 encoder 仍然遵守因果约束,不是传统机器翻译里可看完整输入的双向 encoder。
图中的关键是生成阶段的分工。前缀经过 encoder 后提供全局表示,decoder 使用这些表示产生输出;架构希望降低 prefill 和 decode 各自承担的重复工作。报告给出 552B backbone 参数、prefill 每 token 激活 8B、decode 激活 16B。backbone 参数与包含额外记忆表的总参数口径不同,比较模型卡时必须先对齐。
CSA2 有 Full、Reindex、Reuse 三种模式。Full 重新计算主要 KV 和索引;Reindex 复用主要 KV、重新找相关位置;Reuse 连选择结果也复用。代价逐级下降,但对层间可复用性的依赖逐级上升。这里不是简单“每层都做同一个 Top-k”。
它同时保留滑窗分支,处理局部信息;层次化 indexer 先筛候选再选择注意力位置。读图时把“可看到的上下文”“真正计算注意力的位置”“保留在 cache 的状态”画成三个集合,它们不会自动相等。
01沿图中 encoder / decoder 的分界追踪表示的来源。
02将 global attention 路径与 sliding-window 路径分开看。
03不同阶段的激活参数口径不同,不能用一个 active parameter 数解释全部计算。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
01Full 生成新的主 KV 与索引。
02Reindex 重新选择位置,Reuse 则进一步复用选择结果。
03观察图例中本层计算与跨层复用的颜色区别。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
报告把低信息增益的模型输出、低质量机器翻译视为一种隐式重复。这个观点与“用合成数据扩量”并不矛盾:合成不是质量标签,真正的问题是它带来了新信息、难度或覆盖,还是只是把已有信息换一种说法。
文本与多模态流水线原本分开运行。合并时,重复的文本样本由对应多模态版本替换,epoch 数取两者较大者,最终 text-only 与 multimodal 的 token 比例为 7:1。这是报告中特定最终语料的口径,不能据此算出图像个数或各来源占比。
多模态处理采用由便宜到昂贵的过滤顺序:先筛网页和文档,再抓取图像、重组交错序列,之后做图文感知的去重和质量评分。这样不仅提高质量,也避免给最终会被丢弃的数据付出 CPU、磁盘与模型评分成本。
作者强调 scaling ladder 和整体语料相互作用,而不是仅依靠小模型上的单样本质量分。本站的理解是:一个数据子集在小预算下有益,不保证它在超长训练、混合其他语料之后仍有同样边际收益;需要多规模、多训练时长的验证。
报告给出了可以明确定位的训练时间轴:从头使用 64K 稀疏注意力训练,总量 45T token;在 34T 时扩到 1M。batch 固定为约 100.6M token。学习率经过 2,000 步 warmup 后保持在 直到 28T,在 28T–40T 余弦下降到 ,40T–45T 保持不变。
这说明 长度扩展发生在学习率衰减区间内部。长上下文不是发布前随便改一个 RoPE 参数,也不一定是独立于预训练的第四个大阶段。本网站可以把它放入中训练阅读路线对照,但报告这里的正式标题是 Pre-Training Setups。
优化器按参数类型拆分:线性变换用 Muon,RMSNorm 等非矩阵参数用 AdamW,embedding 与 prediction head 用 Sinkhorn-balanced update,Engram 学习率另有缩放。读新模型时,应先拿到参数分组表,再讨论“用了哪个优化器”。
作者报告训练无不稳定现象,但完整数据清单、逐步日志和全部训练代码没有因这段文字而自动公开。学习者能复原调度形状和参数分组思路,不能声称复现 45T 训练。可做的缩小实验是固定 token 预算,在两种长度切换时间下比较短任务保留和长距离检索。
SWA 的状态跨层累积。想精确恢复多层滑窗 KV,回放的前缀可能远大于单层窗口。报告采用 bounded replay:只回放最近一个窗口,并截断回放段内的滑窗依赖,接受近似状态。
encoder 侧,这使持久前缀 cache 只需保留全局 KV;decoder 侧,回放有界尾部以恢复开始解码需要的局部状态,避免对完整长前缀重新走一遍 decoder。节省的是依赖恢复与重复计算,而不只是“换了更小的数据类型”。
这种状态与完整 forward 不数学等价。 报告明确承认近似,并给出质量影响很小的实验观察;decoder replay 还在后训练中进行模拟适配。一个推理优化因此反过来改变训练分布,这正是 training-aware inference 的具体例子。
调试时要做 cache 命中位置扫描:同一个请求,改变前缀 cache 分割点,比较 logits、答案与吞吐。若只测 cache miss 的质量,再测 cache hit 的速度,就无法发现这个近似带来的风险。这是本站提出的验证方法。
作者明确写出 SFT → RL → OPD 的常规链路,并将主要投入放在任务合成和环境构造。它把任务写成 problem、environment、verification system 三元组,再用难度与正确性检查三者之间有没有矛盾。
这改变了阅读重点:应该问任务如何生成、怎样防止错误判定、如何校准难度、旧任务在新策略下是否仍有学习信号,而不是强行为新版本寻找一个新缩写。报告认为在其设置中数据与环境工程的边际回报很高;这属于团队基于自身实验的判断,不是所有团队通用的定律。
环境故障也必须进入学习记录。模型破坏环境或利用漏洞不能简单“重试到成功”,否则失败会从训练分布中消失。报告描述了沙箱隔离、网络策略以及将环境崩溃视为失败轨迹的处理。
推理 effort 则被显式作为条件输入。对同一问题,不同 effort 的候选分成不同组计算相对优势,长度惩罚随 effort 增大而减弱。不是把长答案一律当好答案:较高 effort 允许花更多 token,但最终仍需正确完成任务。
阅读练习:给两组不同 effort 各写三个候选,记录正确率、长度和奖励;比较“全混成一组”与“按 effort 分组”的优势。前者容易把预算差异误当能力差异。
合上论文后,
留下这几件事。
- 训练、prefill 与 decode 的计算口径需要分开。
- 数据的价值取决于信息增益和混合后的作用,合成与否不是结论。
- 推理近似需要训练适配与专门的质量验证。