Qwen3
从三阶段预训练,读懂能力塑形
 Qwen / Figure 1 / PDF P.9 · 下文逐图讲解
为什么同一个底座在训练后半程需要换数据、换衰减速度、换长度?
Qwen3 的三阶段预训练和两条后训练路径公开得很清楚,是学习 pre / mid / post 接口的关键参照。
原始论文与资料范围
Qwen3 Technical Report
Qwen Team · 发布 2025-05-14 · 查阅 2026-09-22
公开报告不等于完整训练代码或数据已发布;课程不补全未公开实现。
本文选读 35 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗Qwen3 利用视觉模型识别 PDF 类文档,再由语言模型整理文本;同时合成教材、问答、指令、代码等多种格式。这里重要的是数据的新增来源与表达形式,而不是“合成越多越好”。
报告给超过 30T token 做多维标注,涵盖教育价值、领域、主题和安全等,再用小 proxy model 的消融优化实例级 mixture。同一来源内的样本也有差异,所以不是给“网页”一个分数就结束了。
这套做法的优势是能按能力缺口重组语料;成本是标注推理、数据版本维护和大量小实验。公开材料没有列出每个标签的最终系数,不能把实例级优化理解成已经公开完整数据 recipe。
S1 用 4,096 长度训练超过 30T token,建立通用语言和知识,覆盖 119 种语言和方言。S2 仍用 4,096 长度,加入约 5T 更高质量 token,提高 STEM、代码、推理和合成数据比例,并加快学习率衰减。
最后的 Long Context Stage 使用 32,768 长度、数百 B token。长语料中 75% 位于 16,384–32,768,25% 位于 4,096–16,384;RoPE base 从 10,000 提高到 1,000,000。推理时的 YaRN 与 DCA 扩展不要混成“原生全部训练过 128K”。
Qwen 官方在这里称三个阶段为 pre-training。 本站把 S2 与长上下文阶段放入 Mid-Training 路线,是用于比较能力塑形的抽象,不是改写原文术语。
真正的问题是为什么这些能力不全部留给 SFT。S2 以语言建模训练吸收广泛的领域结构;SFT 更直接规定回答与行为格式;RL 则在已有能力支持的输出空间中探索。如果底座从来不会读取复杂代码,昂贵 rollout 很容易全部失败。最后这段是跨论文综合解释。
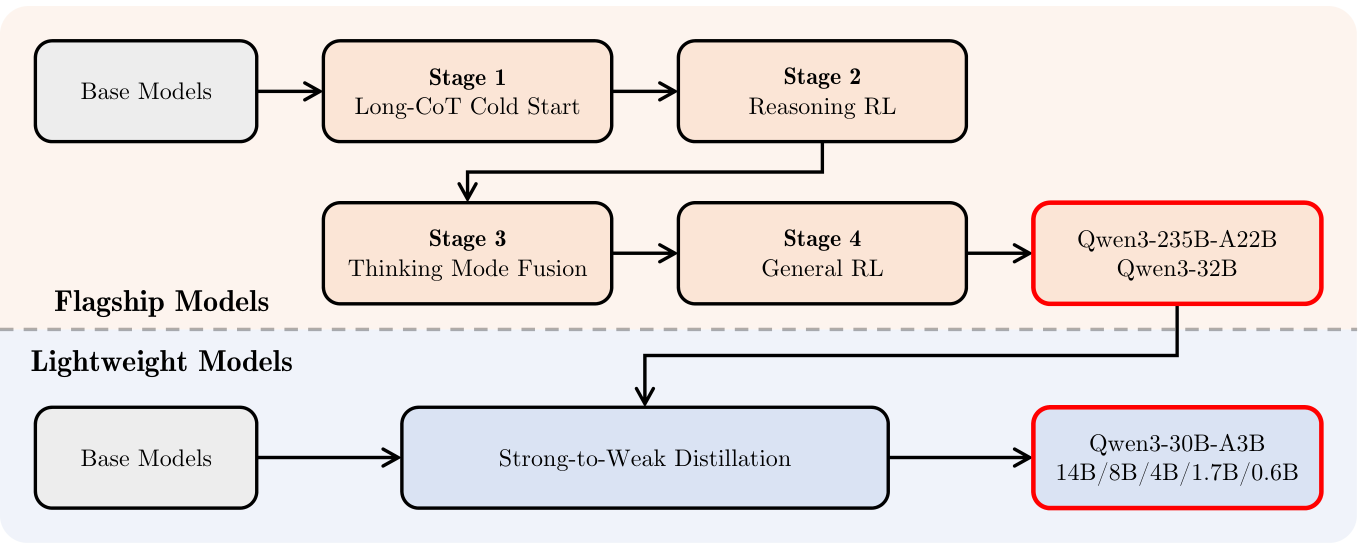
旗舰模型依次经历 Long-CoT cold start、reasoning RL、thinking mode fusion、general RL。轻量模型则走 strong-to-weak distillation。这意味着“Qwen3 的后训练是四阶段”如果不注明范围,就是不完整的说法。
cold start 提供可用的长推理起点;reasoning RL 在可验证问题上提高表现;fusion 将 thinking 与 non-thinking 数据放到可控模式里;general RL 扩展一般任务行为。各阶段更换的监督形式和任务覆盖不同,不只是重复训练更多步。
蒸馏路线把大模型积累的行为迁移到小模型。评测收益因此可能来自教师的数据质量、学生训练方法与底座能力共同作用。读小模型报告时,先问 teacher 是谁、采样预算多少、学生是否在自己分布上学习。
01上半图适用于旗舰模型:cold start → RL → mode fusion → general RL。
02下半图是轻量模型蒸馏路径,不应套用上半图所有阶段。
03同一系列的不同 checkpoint 可能有不同训练历史。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
建议把每阶段记录成 (checkpoint, data version, mixture, context, LR schedule, objective, evaluation)。Qwen3 已公开的信息足够填出主要骨架;未公开的细配比应留空,而不是从其他模型借一套数值。
在本页 mixture 实验里,先提高数学和代码占比,再检查通用能力的变化。它是示意计算,用来建立取舍直觉,不是 Qwen3 的拟合结果。真正复现实验需固定数据样本与 token 总量,保存切换前后 checkpoint,并评测通用语言、领域、长上下文与后续 SFT 的表现。
下一篇读 MiMo-V2.6,观察阶段切换为何进一步包含 optimizer 与精度;再读 Qwen3.8 的负面实验,理解预训练 loss 没有变坏也不能保证后训练接口健康。
合上论文后,
留下这几件事。
- 数据、学习率和上下文长度共同组成阶段设计。
- 官方 pretraining 的内部阶段可以服务课程中的能力塑形问题。
- 同一系列的大模型与小模型并不保证使用同一后训练链。