Kimi K2
从工具库生成任务,再从环境反馈学习
 Moonshot AI / Figure 8 / PDF P.10 · 下文逐图讲解
没有足够的人工工具轨迹,怎样生成值得学的数据?
K2 把工具使用的数据合成、真实执行和可验证 RL 写得具体;同时为 K3 的 optimizer 与数据演进提供参照。
原始论文与资料范围
Kimi K2: Open Agentic Intelligence
Moonshot AI · 发布 2025-07-28 · 查阅 2026-09-22
公开报告不等于完整训练代码或数据已发布;课程不补全未公开实现。
本文选读 32 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗K2 对 Muon 训练中的 attention logit 增长引入 MuonClip 稳定化。需要追踪的是 Q/K 尺度与注意力数值行为,而不是看到 loss spike 就先降低全局学习率。报告的稳定训练曲线是特定设置的观测,不是对所有 Muon 配方的保证。
数据侧,作者比较原文重复、一次改写后重复、多次改写各训练一遍,在其 SimpleQA 实验中观察到多样改写的收益。完整文档用 chunk-wise autoregressive rephrasing 维持连贯,并做 fidelity verification。
这个结果与 V4.1 对低信息增益合成内容的警惕值得一起读:改写能改善表达多样性,但也可能变成隐式重复。两篇使用的语料、模型、训练时长与验证方式不同,不能把某个局部实验升格成“改写总有益”或“合成总有害”。
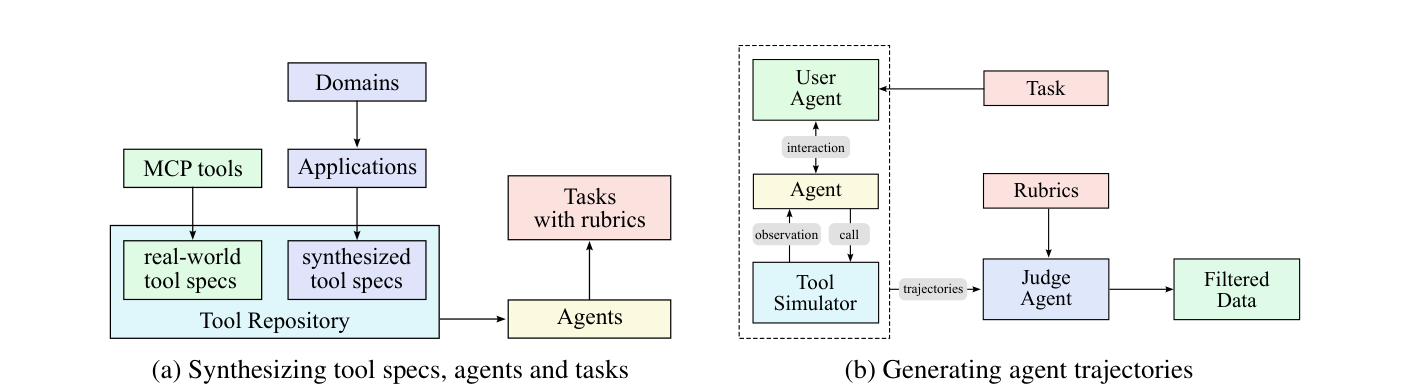
流程从真实工具与合成工具组成的 tool repository 开始,再生成具有能力范围的 agent 和相应任务。任务 rubric 提前定义成功条件,随后由交互过程产生轨迹,经过质量评估与筛选后用于 SFT。
工具执行环境的一部分是有状态模拟器:每次工具调用会更新模拟状态,并产生成功、部分失败或边界情况。模拟反馈不是实际执行证据。 报告明确用真实 sandbox 补充需要真实性的 coding / SWE 场景,让代码和测试真的运行。
这种合成与筛选可以理解为大规模 rejection sampling:先生成多种行为,再保留满足标准的示范。它能扩大覆盖,但成功轨迹筛选会丢掉某些有价值的恢复过程;后续 RL 才让模型在失败反馈中优化策略。
01工具从哪里来?区分真实 MCP 规格和合成规格。
02任务由谁构造,rubric 在什么时候定义?
03最后保留的是经过评估的轨迹;模拟环境和真实 sandbox 不应混写。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
RL 环境覆盖数学、STEM、逻辑、复杂指令和代码任务。作者用 SFT 模型的 pass@k 估计难度,选择适中的题目:全对组缺少差异,全错组缺少可用成功信号。题目难度必须相对当前 policy 定义,不是永久属性。
SWE 从真实 issue / PR 和测试构建环境;报告描述可并发运行大量 sandbox 的基础设施。这个数字表示环境容量,不是同一时刻训练 GPU 的数量。CPU、磁盘、镜像构建与网络依赖也会限制 rollout。
复杂指令采用代码规则和模型判断结合,并加入 hack 检查。这里评分器的错误可能被策略逐步放大,因此训练 reward 上升必须由独立评测验证。
开放任务没有像单测那样清楚的答案,K2 用 rubric 约束的 critic 对候选做成对评价。critic 能力先用偏好数据初始化,再通过可验证任务的反馈持续校准。
因此“self-critic”并不是裸模型随便给自己满分。它包含外部规则、偏好标注与可验证信号的锚定。但这种锚定不能消除主观偏好或共同盲点,仍需独立审计和跨分布评测。
练习:选择一个有真实工具的任务,写出模拟环境可能错误允许的动作、真实环境会如何反馈、grader 怎样发现差别。随后运行 agent-loop 教学实验,观察错误奖励怎样让 policy 学到错误捷径。
合上论文后,
留下这几件事。
- 合成轨迹的可靠性取决于执行环境与筛选标准。
- 难度应相对策略动态估计。
- 模型评分需要外部锚定,不能用同源自证代替正确性。