Let’s Verify Step by Step
最终答案之外,怎样评价推理过程
 OpenAI / Figure 3 / PDF P.7 · 下文逐图讲解
过程奖励更好,这句话在论文中到底指哪一种实验?
这篇能建立 process supervision 的准确边界:先区分训练奖励模型、用它选答案与直接用它训练 policy。
原始论文与资料范围
Let’s Verify Step by Step
Lightman et al. / OpenAI · 发布 2023-05-31 · 查阅 2026-09-22
引用公开论文的结论范围;没有完整代码的训练细节不从论文推测。
本文选读 29 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗Outcome supervision 对完整答案评价,process supervision 则给推理步骤标注。PRM 因而获得更密集的错误位置线索,但需要大量步骤级人工判断,且“这一步可接受”可能存在标注歧义。
PRM800K 的价值不仅是量,而是明确的步骤与标签定义。过程中的格式切分、负面步骤出现后怎么继续、正确但不常见的解法怎样标,都影响奖励模型究竟学到什么。
语言看起来合理不等于数学有效。 过程评分器也可能偏爱熟悉的推导模板,或被正确开头欺骗;最终答案检查仍然有独立价值。
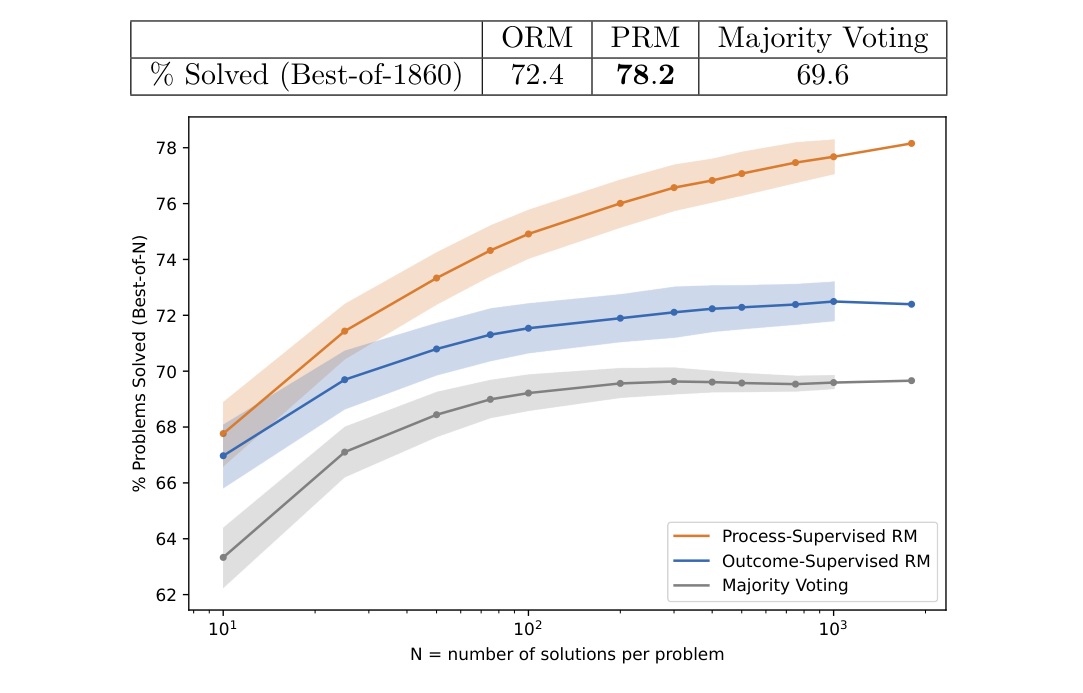
实验让生成器为同一问题产生多份候选,再分别用 outcome-supervised 与 process-supervised reward model 选择答案。横轴是候选数量 N,纵轴是选出的答案正确率。
在作者的 MATH 设置里,PRM 随 N 增加取得更好的选择表现。但这是 reward model 的搜索/选择能力,不能直接改写成“PRM RL 已在所有模型上优于 ORM RL”。生成器与候选池保持一致,才能把差异较合理地归到评分器。
多候选有明显计算成本,且候选越多越容易出现迎合评分器的错误答案。应看整条曲线是否饱和或退化,并记录筛选成本。Figure 3 的置信或变化范围也应保留,不能只抄最高点。
01相同候选生成条件下,改变选择答案的 reward model。
02横轴 N 增大意味着更多推理计算,不是免费获得更高能力。
03这张图支持 best-of-N 的比较,不自动支持端到端 RL 的结论。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
数学中可标注的“步骤”,到代码 agent 会变成读取文件、运行测试、修改 patch 等动作。一个暂时失败的测试可能是有价值的诊断;一个看似顺畅的轨迹也可能绕过真实任务。过程评价必须依赖环境状态和任务目标。
本站综合分析:长任务的过程监督既需要局部证据,也需要终局约束。MiMo 的乘法奖励保留测试门槛,再加实现与行为质量,提供了一条可比较的路线,但不能宣称它与本篇 PRM 的监督形式完全相同。
练习:给同一最终正确答案写两条不同过程,一条包含无效绕路,另一条使用不常见但正确的简洁方法。写出 grader 应看什么证据,什么判断必须保留不确定。
合上论文后,
留下这几件事。
- 步骤级监督成本与歧义需要计入方案。
- 先区分评分器选择能力与 policy 训练能力。
- Agent 的过程质量必须结合可执行状态与结果。