DeepSeekMath
GRPO 之前,先看它怎么得到数学数据
 DeepSeek / Figure 4 / PDF P.13 · 下文逐图讲解
省掉 value model 之后,优势从哪里估计?
这篇不仅是 GRPO 原始论文,也是数据构建与领域继续训练如何为 RL 建立起点的直接案例。
原始论文与资料范围
DeepSeekMath
Shao et al. / DeepSeek-AI · 发布 2024-02-05 · 查阅 2026-09-22
引用公开论文的结论范围;没有完整代码的训练细节不从论文推测。
本文选读 30 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗作者从数学种子数据出发,训练分类器筛选 Common Crawl,再分析命中域名、补充种子、迭代召回。这里不是仅搜索带有数学符号的网页:数学文本的表达和语言分布比规则匹配丰富。
DeepSeekMath 从代码模型继续预训练,并比较不同数学语料的收益。要把“更好的数据”“代码起点”“数学训练”“SFT”“RL”分别记到实验表里,不能把最后成绩全算给 GRPO。
这种数据构建方法能够扩展候选池,但也会受种子覆盖偏差影响。需要去重、污染检测和跨语言评测;一个分类器高分不等于每个推导都正确。
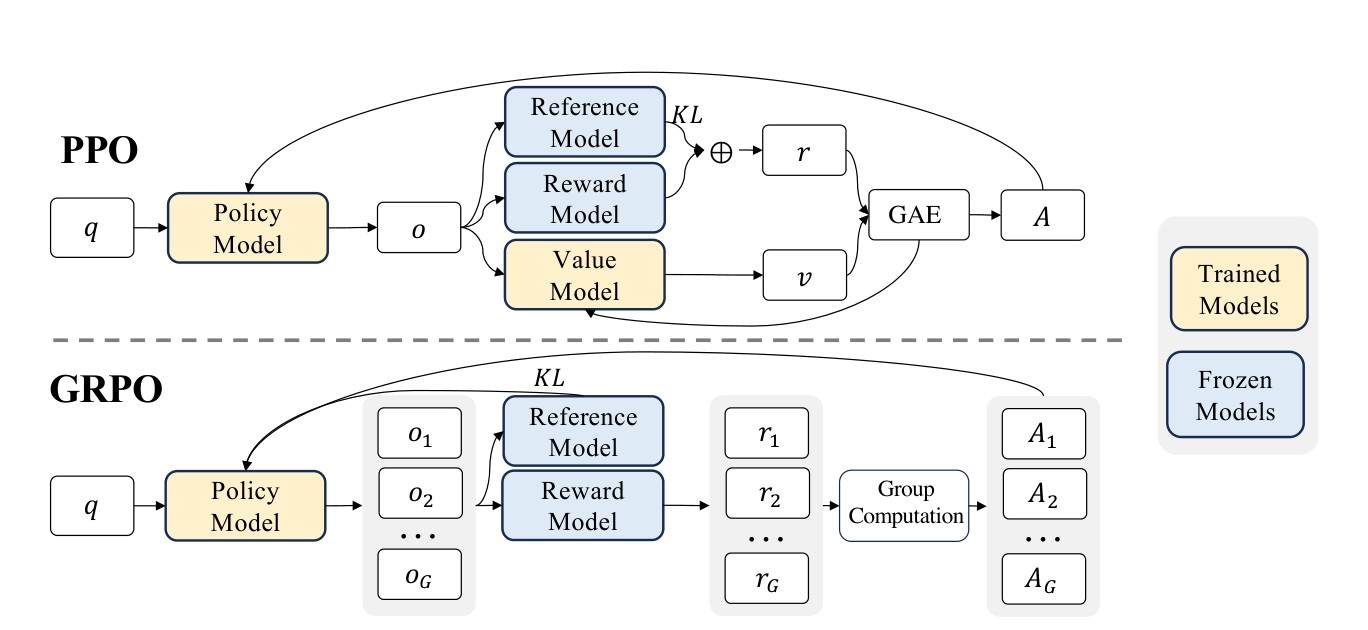
PPO 通常训练 value model 来估计 baseline。GRPO 对同一个问题采样 G 个回答,用组内分数构造相对优势,减少 value model 的资源成本。Figure 4 右侧 Group Computation 正是被替换的接口。
结果监督下,可以用 建立直觉。例如奖励 [0,0,1,1],用 population 标准差 0.5 得到 [-1,-1,1,1];同一序列的 token 共享该序列信号。若全为 1,组内没有差异,主策略梯度没有新的质量偏好。
省 critic 不等于不花采样计算。 G 个候选需要 rollout;任务太容易、太难、奖励错误或方差极低,都可能浪费大量生成 token。现代训练里的难度控制和动态采样因此不是外围功能。
01PPO 的 value model 为每个状态提供估计。
02GRPO 改用同题多个输出的组分数,reference 和 reward 的角色仍在。
03图不表示长轨迹的每个动作都得到了独立正确的信用分配。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
目标先用新旧策略的 token 概率比乘优势,再用 clipping 限制过大的更新;另加 reference KL 正则。优势决定往哪个方向学,ratio 处理采样分布差异,KL 则限制相对参考策略的偏离。
报告在 loss 中直接加入 KL,而不是先把 KL 放进 reward 再归一化优势。两种位置会改变有效信号。不同后续 GRPO 变体还改变长度归一化、组标准差和 token mask,因此不能只对照算法名字。
对长 agent 轨迹,给所有动作相同终局优势是粗粒度 credit assignment。一条成功轨迹里可能包含无用步骤;它们不会因为叫 GRPO 就自动被识别。这也是后续 process reward 和 MiMo 的行为评分值得读的原因。
先打印每个问题的组奖励和 std,而不只看平均 reward。再检查有效 token mask、old log-prob 与 response token 是否对齐。最后比较训练 reward 和独立准确率是否同步上升。
把同样的奖励复制成不同长度回答,比较 sequence-average 与 token-average 两种归一化下的权重。这个小实验能揭示模型为什么可能受到长度偏置;不能把教材里一种归一化悄悄当成所有生产框架的实现。
本页提供真实 policy 更新的缩小 agent 实验和源码导读入口。它们用于检验数据流与优势计算,模型是有限策略表,不冒充复现 DeepSeekMath 的语言模型训练。
合上论文后,
留下这几件事。
- 数学数据和领域训练决定 RL 起点,GRPO 不是全部贡献。
- 组内比较省掉 critic,但增加 rollout 与难度控制的需求。
- 优势、概率比、KL 和归一化需要逐项核对。