Direct Preference Optimization
沿着公式,看奖励模型怎样消失
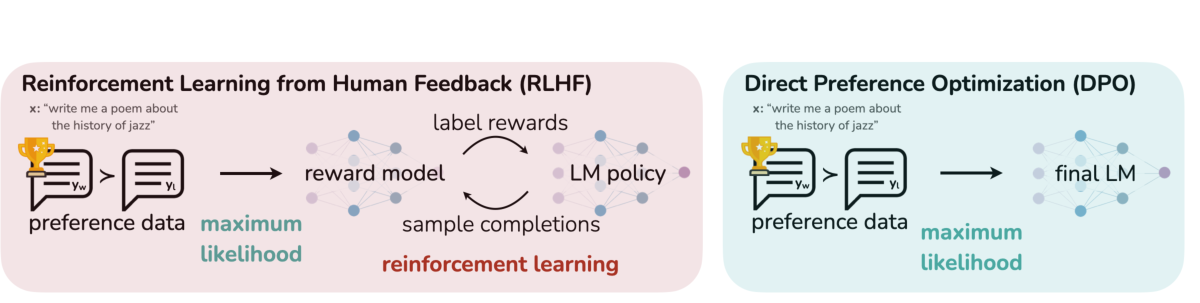 Stanford / UC Berkeley 等 / Figure 1 / PDF P.2 · 下文逐图讲解
能否直接用好坏答案对训练 policy,而不先拟合一个独立奖励模型?
DPO 的推导短而关键。读清楚重参数化、reference 和数据支持范围,才能判断何时值得用离线偏好优化。
原始论文与资料范围
Direct Preference Optimization
Rafailov et al. / Stanford · 发布 2023-05-29 · 查阅 2026-09-22
引用公开论文的结论范围;没有完整代码的训练细节不从论文推测。
本文选读 27 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗起点是 。在相应假设下,最优策略与 reference 乘以指数奖励成比例:。
将它反解成奖励,得到 。Z 难算,但同一个 prompt 的两个回答相减时,这一项会抵消。DPO 的关键是这个变量替换,而不是凭直觉提高好答案概率。
01左侧先训练 reward,再通过 RL 训练 policy。
02右侧直接用偏好对更新 policy;reference 仍进入概率比。
03系统简单了,但偏好数据和初始分布仍决定学习边界。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
令 chosen 为 ,rejected 为 ,则
对数概率是回答序列的 token log-prob 之和,只计算 answer 部分,prompt 与 padding 必须 mask。reference 固定,policy 反传;chosen 与 rejected 的 prompt 必须一致,才符合上面的抵消。
若两者相对 reference 的变化都为零,括号为零,loss 为 。优化促使 chosen 相对 rejected 的 log-ratio 增大。它不保证 chosen 的绝对概率每一步都增加,因此只监控偏好 margin 会漏掉整体概率变化。
训练时应同时记录 chosen/rejected log-prob、隐式 reward margin、长度和独立生成评测。β 不只是一根简单的“更保守”旋钮;有限数据与参数化训练中,应通过验证而不是口头解释选择。
固定偏好库只覆盖已观察到的候选。DPO 本身没有替你探索新工具策略或构造环境,因此在长任务状态分布变化很大时,可能需要迭代收集新偏好,或改用在线训练。
偏好差异也可能来自长度、格式或标注捷径。模型学会迎合 judge,不等于事实或代码质量变好。把偏好对随机拆分会保留同题或相似模板泄漏,评测应按任务来源和去重组划分。
本页 preference 实验可以逐步调整两个候选的概率,看 loss 与 reference 的关系。真实实现导读指向已核验的 TRL 源码;教学计算不是 TRL 的完整 trainer,不包含分布式、packing 与 reference cache。
合上论文后,
留下这几件事。
- DPO 用最优策略与奖励的关系重参数化偏好学习。
- 只优化回答 token,保持 prompt 与 reference 口径一致。
- 离线数据不能自动覆盖 policy 将来遇到的所有状态。