InstructGPT
把示范、偏好和策略优化分开看
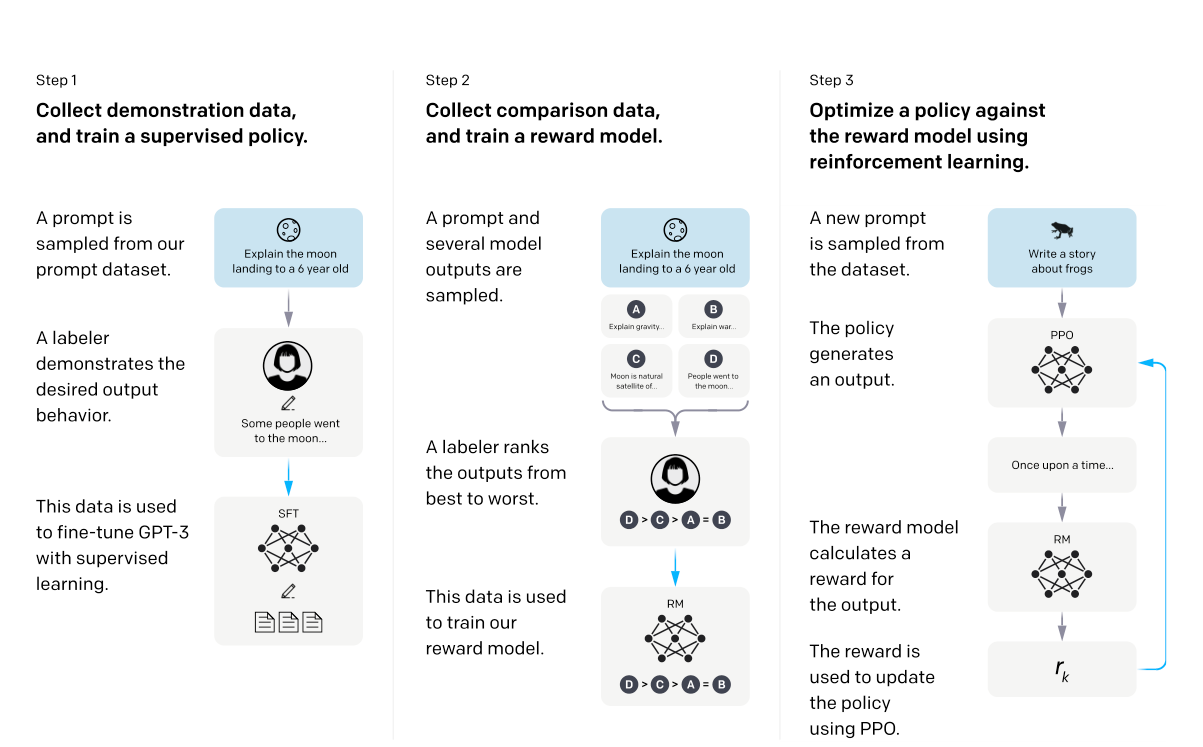 OpenAI / Figure 2 / PDF P.3 · 下文逐图讲解
人类更喜欢的回答,怎样变成可优化的信号?
不是用它概括今天全部后训练,而是用这张经典系统图建立参照,之后才看得懂 DPO、RLVR 和在线蒸馏删改了哪些部分。
原始论文与资料范围
Training language models to follow instructions with human feedback
Ouyang et al. / OpenAI · 发布 2022-03-04 · 查阅 2026-09-22
引用公开论文的结论范围;没有完整代码的训练细节不从论文推测。
本文选读 68 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗第一步收集人类示范,SFT 学习给定 prompt 应怎样作答;第二步对同一 prompt 的多个模型回答排序,训练 reward model;第三步由当前策略生成新答案,通过 reward model 得分,用 PPO 更新策略。
偏好数据不是正确答案文本。 一条示范直接给可模仿序列;一个排序只告诉你相对选择;rollout 又来自正在变化的策略。把它们混成“instruction data”会漏掉系统最关键的分布差异。
这张图也解释了资源开销:policy 需要训练,reward model 需要打分,reference 用于约束偏移,value 估计帮助构造低方差优势。之后 DPO 与 GRPO 的贡献,恰好可以对照它们移除了哪一种角色。
01人类在第一步提供示范,在第二步提供排序。
02第三步的回答由当前策略采样,而不是从固定示范库读出。
03奖励模型只是偏好代理,策略优化仍需控制偏离。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
可以把优化目标理解为提高 learned reward,同时通过 KL 惩罚限制策略偏离 reference。reward model 只在有限偏好数据上训练,策略若远离该分布,可能找到模型的盲点而不是用户喜欢的行为。
论文还观察到部分公共 NLP 能力回退,PPO-ptx 混合预训练分布的语言建模更新以缓解。行为对齐和基础能力保留需要同时评估,并不因为偏好胜率上升就全部解决。
这不是“PPO 天生让模型变笨”的结论。数据分布、目标权重和评测范围共同作用;应看同一实验里的对照,而非从个别任务概括一切。
标注者选择、任务分布和标注规则决定模型对齐的对象。论文讨论 held-out labeler 的泛化,但这并不能代表全部文化、专业领域和冲突价值下的偏好。
实践中至少记录 prompt 来源、候选生成模型、采样设置、排序规则和标注分歧。一个 reward model 可以在测试排序上准确,却在被策略反复优化后出现 reward hacking,因此需要 on-policy 审计。
继续读 DPO 时问“它是否省掉了显式 RM”,读 R1 时问“是否换成可验证结果”,读 MiMo 时问“评分系统为何又变得复杂”。这三条不是简单的新算法替代旧算法,而是不同监督条件下的路线。
合上论文后,
留下这几件事。
- SFT、RM 与 RL 分别消费不同形式和分布的数据。
- 奖励模型是代理目标,需要评测分布与 KL 约束。
- 偏好提升与通用能力保留应分开测量。