Chinchilla
先学会给参数和数据分预算
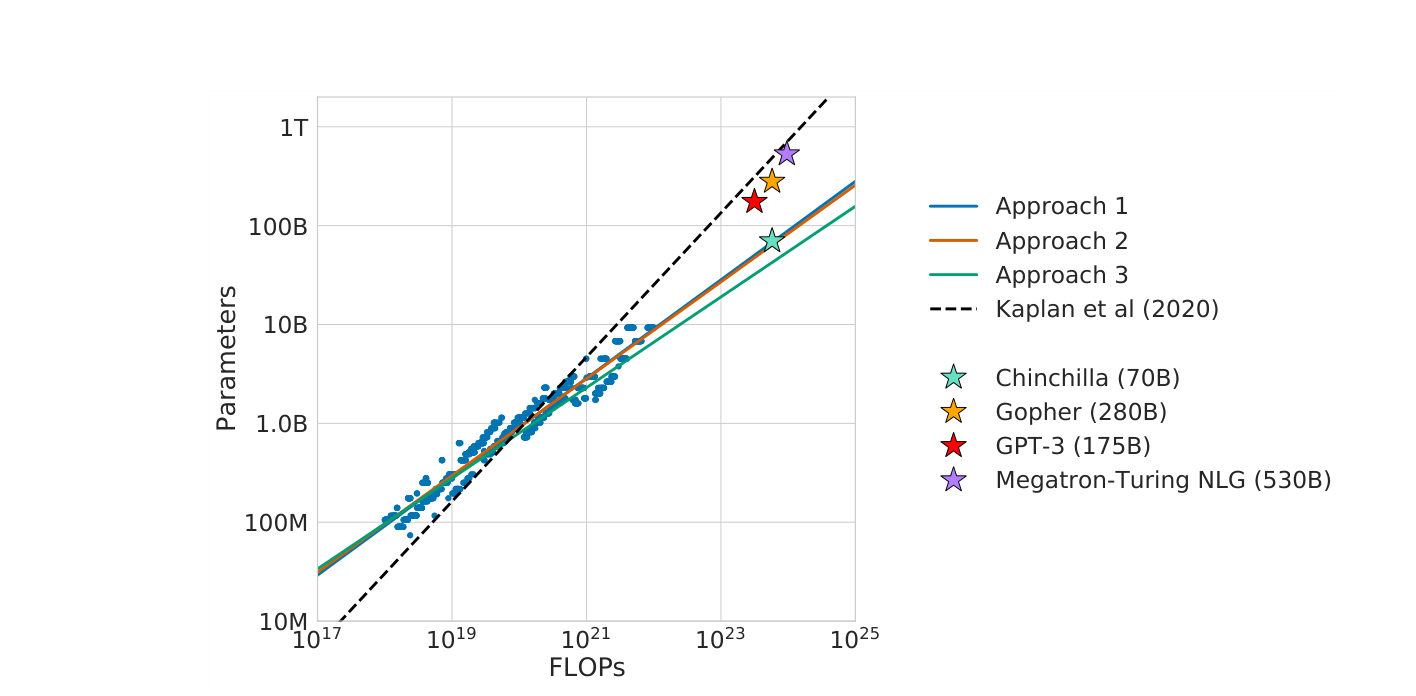 Google DeepMind / Figure 1 / PDF P.2 · 下文逐图讲解
同样的训练 FLOPs,模型越大越好吗?
它提供后续所有预算讨论的参照,但不是今天每个部署场景都必须遵守的参数/token 比例。
原始论文与资料范围
Training Compute-Optimal Large Language Models
Hoffmann et al. / DeepMind · 发布 2022-03-29 · 查阅 2026-09-22
引用公开论文的结论范围;没有完整代码的训练细节不从论文推测。
本文选读 36 页报告中的关键部分;中文说明是本站解读,原图来自对应报告。开放权重、推理代码与完整训练配方是不同的披露范围。
查看来源、版本与许可记录 ↗论文比较不同参数量 N、训练 token 数 D 在计算预算 C 约束下的最终 loss。用常见近似 理解:把参数加倍,就必须减少 token,二者争夺同一笔预算。这个近似面向特定 dense Transformer 训练估算,不含所有通信、数据和服务成本。
它用训练曲线包络、IsoFLOP 扫描和参数化 loss 拟合三条路线交叉检查。Figure 1 的意义不是给一个神奇常数,而是观察这些估计是否指向相近的预算分配。
比较时要固定什么,决定了什么叫最优。 固定训练 FLOPs 的最优,和固定部署延迟或全生命周期费用的最优,可以不是同一个模型。
01不同方法对同一计算预算推断最佳参数量;再结合预算判断 token 分配。
02观察方法之间是否一致,再看外推范围。
03坐标中的 compute 指训练预算,不能包含原文没有建模的服务成本。
原图版权归论文作者或所属机构;为论文评析摘录,未修改图内信息。
参数化模型写作 。E 是不可约项,后两项表示参数不足与数据不足带来的损失。预算固定时,选择 N 与 D,使两边的边际收益协调。
这能解释为何只扩大模型、保持相近训练数据会出现欠训练。Chinchilla 的验证模型用 70B 参数、1.4T token,与更大但 token 较少的 Gopher 比较。它支持该数据与训练设置下更均衡的分配,而不证明任何语料重复 1.4T 都有同样效果。
之后的 MoE、合成数据、低精度和推理成本会改变问题。MoE 的总参数不等于激活参数;更高质量 token 也不等同于随便增加 D。因此读现代报告时应重拟合,而不是把 20 token/parameter 当法规。
实验先选多个小规模模型与 token 预算,保持数据来源、评测集和调度口径一致,再画同 compute 切片。记录最终 loss,也记录每个 domain 的评测。只用最后几个点拟合一个指数,很容易把噪声或学习率调度效应当 scaling。
本站建议增加真实 GPU 小时这一列。理论 FLOPs 相同的两种训练可能因为通信、padding 或重计算而耗时不同。若最终目标是部署小模型,多训练 token 可能值得,因为一次训练开销可以换来长期服务节省;这属于扩展目标后的分析。
继续读 V3,观察稀疏参数与实际集群如何改变预算;再读 Qwen3,观察同一个 token 总量内部的数据阶段为何不同。
合上论文后,
留下这几件事。
- 先定义预算与目标,才能讨论最优参数量。
- 训练 token 的质量和计算实现会改变 fitted scaling。
- 经典规律提供实验设计方法,不替你选择最新配方。